"中台建好半年了,业务部门反馈就八个字:数据不准,不敢用。" 这是一位制造业CDO的原话。不是中台技术不行——数据集成跑通了,报表能出了,可视化大屏也亮了。但财务说"你的数和ERP对不上",销售说"客户信息全是重复的",运营说"算了我们还是用Excel吧"。 根源只有一个:数据质量不过关。 中台的价值是让数据可复用。但如果数据本身是脏的,复用的不是资产,而是错误——而且越复用,错得越远。下面用五个最常被问到的问题,聊聊数据质量这件事到底怎么落地。 Q1:数据质量问题到底有多普遍? 比大多数人以为的严重得多。 华东某数据局在引入数据质量管理服务之前,做过一次摸底:各部门提交到数据资产平台的目录,初始合格率只有6.34%。这不是说数据"有点小毛病",而是说94%的目录存在命名随意、描述缺失、字段类型错误等基础问题。业务数据里的问题更触目惊心——教育系统里"同一个学籍号对应多个学生姓名",司法系统里"结案时间早于立案时间"。 制造企业的情况也好不到哪去。同一物料在不同系统里有三个叫法,订单表的客户名称字段有几百条空值,BOM版本号和ERP里的对不上。这些都不是偶发问题,而是系统性地存在。 结论很简单:数据质量问题不是"有没有",是"有多严重"。大多数企业严重低估了自己数据的脏乱程度。 Q2:为什么建中台之前没发现? 因为建中台时的关注点全在"接数据"上,没人在"验数据"。 数据集成的工作逻辑是:把ERP、MES、CRM等系统的数据搬到中台来。搬的过程解决了"通不通"的问题,但没解决"对不对"的问题。集成只管搬,搬完之后数据准不准、全不全、有没有重复——没人检验。 等业务部门实际用的时候才发现不对劲,但这时候数据已经进了中台,随下游任务扩散了好几轮。更麻烦的是,因为缺少元数据记录,出问题之后连"这数据从哪来的、被谁改过"都追溯不清楚。 Q3:怎么判断数据质量过不过关? 国家标准 GB/T 36344-2018《信息技术 数据质量评价指标》[1]定义了六个评价维度:完整性、准确性、一致性、唯一性、时效性、可访问性。除可访问性外,其余五个维度直接影响数据的可用程度。 落到实操层面,可以这样理解: 完整性:该有的字段有没有?比如订单表里客户名称不能为空。 准确性:数据对不对?比如"结案时间"不能早于"立案时间"。 一致性:同一个数据在不同系统里是否一致?比如CRM里的客户名和ERP里的是否相同。 唯一性:有没有重复记录?比如同一张订单不能出现两次。 时效性:数据是不是最新的?比如库存数据是今天的还是上周的。 实践中,对这些维度的检查可以通过旁路监测的方式来做——质检规则不对数据入库做任何拦截,数据正常入库,质检任务并行扫描,发现问题后打标记、发告警、生成整改工单。既保证了数据流转的效率,又确保了问题可发现、可追溯。 Q4:发现问题之后怎么修? 关键是闭环,不是打地鼠。 华东某数据局的实践提供了一个完整参考。他们的做法是建立"质量监测→发现问题→派发工单→部门修复→复验归档"的闭环流程: 常态化扫描全域数据,自动生成问题台账 点对点推送至责任部门,明确"哪个表、哪个字段、什么问题" 部门修复后自动复验,通过后归档 沉淀为问题修复知识库,同类问题不再从头摸索 经过多轮治理,各部门修复率超过93%,目录合格率从6.34%提升至94.74%,累计沉淀1000余项质量监测规则。关键是这套机制融入了日常运维,不再是"一次性运动"。 Q5:有没有轻量级的起步方案?不想一上来就上重型平台。 有。数据质量不需要重型平台起步。 如果团队规模不大、预算有限,或者只是想先摸清家底,可以先从数据体检开始——用轻量工具扫描核心业务表,看看到底有多少字段缺失、多少格式错误、多少重复记录。知道问题在哪,才知道下一步该投入多少。 康桥数据质量管理平台 版就是为此设计的:免费可用,一行命令部署,10到20分钟就能跑起来。内置12类质检规则(空值检查、唯一性检查、格式规范性检查、一致性检查、逻辑检查等),全部可视化配置,不需要写SQL。四步完成一次完整的数据质量评测:接入数据源→自动采集元数据→配置评测规则→查看问题统计。 先做一次体检,摸清底数再决定后续投入。这条路不重,但能让你第一次真正看清自己的数据到底有多"脏"——或者多"干净"。 数据质量不是大厂的专利。目录合格率能从6.34%做到94.74%,说明只要方法和机制对,数据的"脏乱差"是可以治的。关键是先迈出第一步——先做一次体检,知道问题在哪,就成功了一半。 参考来源 1.GB/T 36344-2018《信息技术 数据质量评价指标》,国家市场监督管理总局、中国国家标准化管理委员会,2018年6月7日发布,2019年1月1日实施。https://std.samr.gov.cn/gb/search/gbDetailed?id=71F772D82DFCD3A7E05397BE0A0AB82A
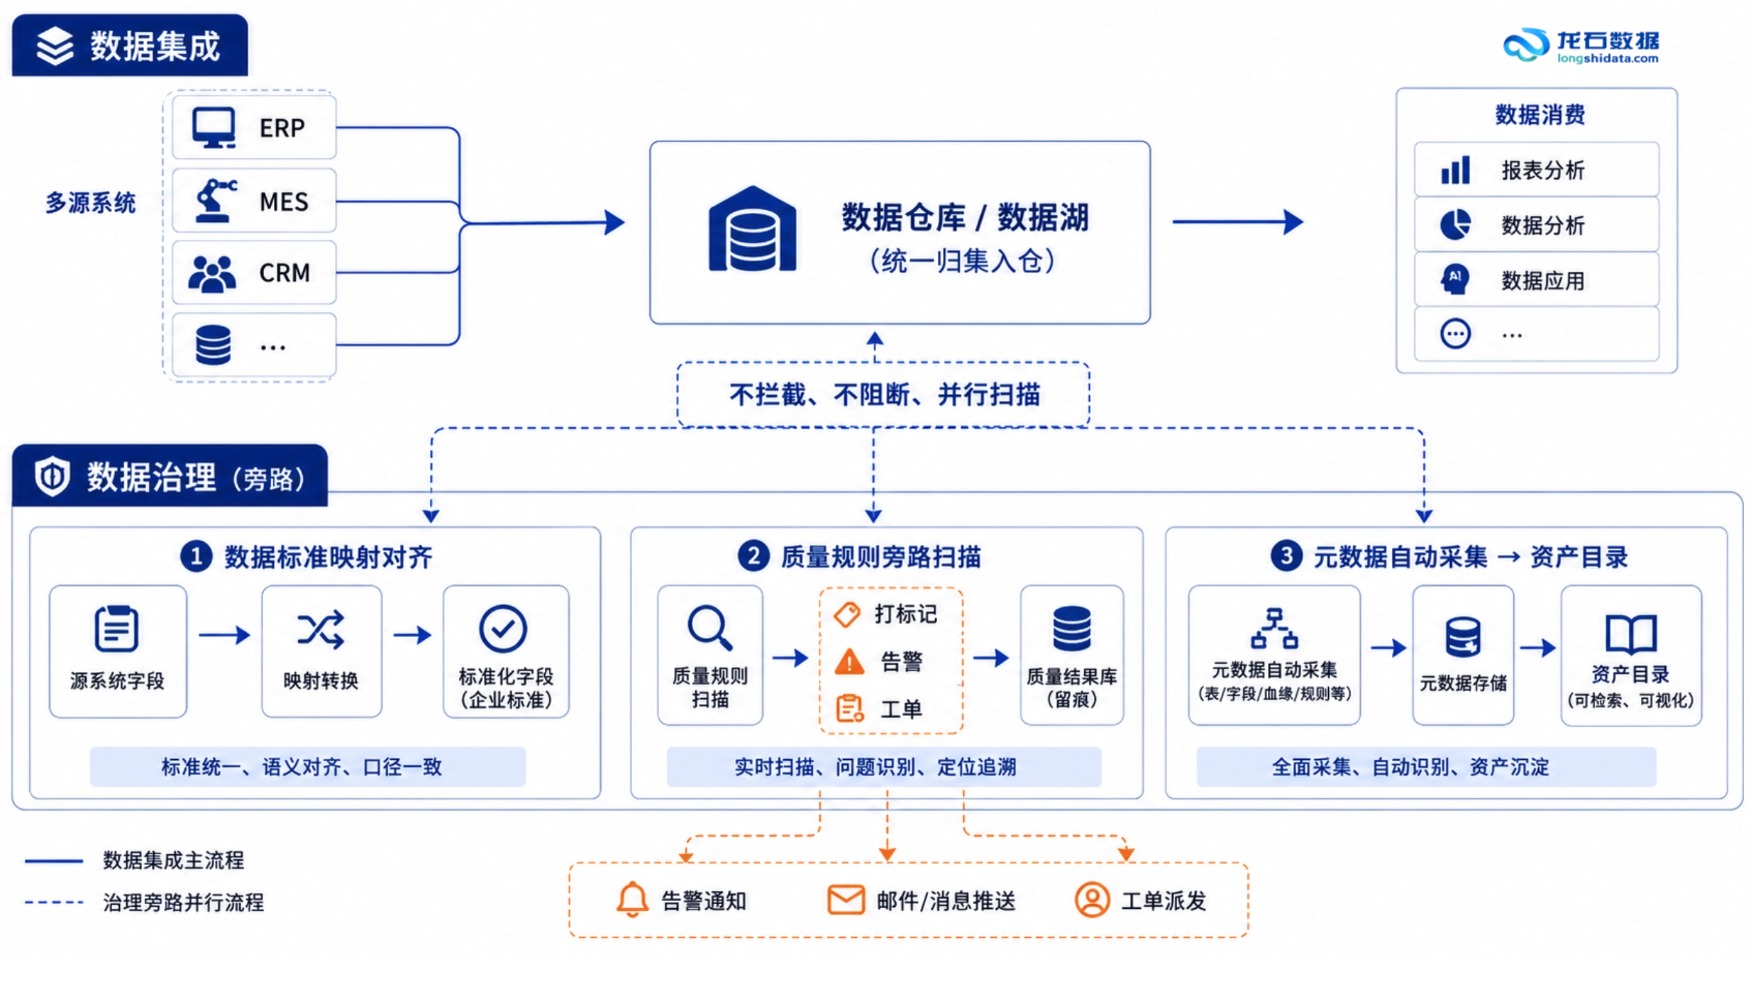
"我们中台搭了快两年,ERP和MES的数据到现在还没跑通。" 这话来自一家制造业企业的CDO,说的时候他苦笑了一下。不是缺工具——Kettle、DataX都在用,开发团队也不弱。问题是每接一个新系统,光接口适配就要耗掉半个人月,而且"接完只是开始"——数据对不上、字段含义靠猜、出问题不知道从哪追。 这不是个例。在参与过的项目中,异构数据集成几乎每次都是中台建设的第一道坎,也是耗时最长的一道。 一、不是技术不够,是"接不住" 数据中台建起来,第一件事就是往里面接数据。理论上有数据集成工具就行,但现实比理论复杂得多。 首先是数据源类型多。数据库不只是MySQL,还有Oracle、SQL Server、PostgreSQL,不同版本接口行为各异。加上API对接的SaaS系统、文件交换的遗留系统、消息队列流转的实时数据——一个企业少则三五套系统,多的十几套。然后是对接技能要求高。ERP里的"客户名称"、CRM里的"客商名称"、财务系统里的"往来单位",指向同一个东西,但集成人员得一个一个去对应。这还只是一个字段。实际情况是,一个核心业务表可能有几十上百个字段,全靠人工逐个映射,工作量极大。 江苏某自动化制造企业在建设数据中台时,光是把ERP、PLM、MES、SCADA、质量系统五套核心业务系统打通,就花了好几个月。不是技术方案复杂,而是各系统的数据字典差异太大——同样的"订单号",在不同系统里长度、格式、含义都不完全一致。 二、接进来了,然后呢——三个根因 数据集成常见的困境是:第一阶段把数据接进来了,以为大功告成,但很快发现接进来的数据用不了。这才是真正的问题。 根因1:标准前置缺失,映射全靠人工 如前所述,字段名称不统一只是表层。更深层的问题是缺乏统一的数据标准体系——字段的业务含义、格式规范、取值范围、编码规则,如果不在集成前定义清楚,集成就变成了"硬接"。[1] 某跨区域运营的多元化产业集团旗下覆盖多个业务板块,同一个物料在不同板块间能有三种叫法,同一个供应商在多个业务系统中有独立编码。在没有统一主数据标准的情况下做集成,数据汇聚之后口径打架,报表分析全是错的。跨板块对账需要数天,数据纠纷常年不断。 根因2:元数据不跟进,血缘一片空白 比字段映射更隐蔽的问题是元数据缺失。很多人理解的集成就是把数据从一个系统搬到另一个系统——但搬的过程做了什么转换?原始数据是什么?被谁在哪一步改过?这些信息如果没有记录,后续出了任何问题都无法溯源。 没有元数据管理的数据中台,就像一个没有库存清单的仓库:东西都放进去了,但不知道放了什么、从哪来的、什么时候入库的、有没有被人动过。数据量的增长反而加剧了混乱——仓库越大越找不到东西。 根因3:质量校验缺位,数据进来了却没人管质量 这是最典型却最容易被忽略的问题。集成只管"搬",搬完之后数据对不对、全不全、重不重——没人检验。字段缺失、格式错误、逻辑矛盾这类问题在集成阶段没有被发现,等业务部门用数据做分析时才发现结果离谱,回头追溯已经过了好几手。[2] 江西某国控集团在建设中台前,10余套业务系统的数据缺乏统一的质量管控——财务数据填报错误、投资项目信息缺失、指标口径不一致,监管决策的依据本身就不可信。这些问题不解决,集成的数据越多,错误放大的范围就越大。 三、四个常见误区 误区1:把集成当纯技术活。 认为选对工具就能搞定——DataX不行换Kettle,Kettle不行换Flink。但实际上异构数据集成的瓶颈不在传输性能,而在业务语义的对齐。没有数据标准的集成工具,就像一个翻译软件只懂语法不懂语境。 误区2:等全接完了再治理。 不少团队的思路是先把所有系统的数据汇聚进来,后面再统一治理。问题在于,数据一旦入库,错误就会随着下游任务扩散——等发现的时候已经分不清哪些数据是干净的、哪些经过了污染。集成和治理更适合并行推进,而非先后串行。 误区3:追求"一键接入"。 任何做过系统对接的人都明白,现实中没有真正的一键接入。每个系统都有自己的历史包袱和业务特殊性,对接过程必然需要业务人员参与确认语义、校验口径。工具可以减少重复劳动,但不能替代业务对齐。 误区4:忽视元数据。 规模越大越需要元数据。如果不知道数据从哪来、谁改过、给谁用,数据中台很快就会变成一个巨大的"黑箱"——所有人都在往里放数据,没有人知道里面到底有什么。 四、解决路径:集成与治理并行 核心思路一句话:数据的采集和治理不是先后关系,而是并行关系。[3] 数据集成负责归集,不拦截数据。 数据中台通常不建议在采集链路中修改或拦截数据——数据原样入库是行业实践中较为稳妥的做法,便于后续审计追溯。如果在采集链路里做格式转换或校验阻断,出了问题难以排查:是源端数据本来就有问题,还是中间转换环节改了数据? 治理在入仓后立即启动。 数据进入中台后,数据标准模块做字段到业务语义的映射对齐——不是在采集链路中硬性转换,而是在治理层建立标准与源数据的对照关系。同时元数据自动采集,让每张表、每个字段都有来源、有去向、有变更记录。 质量管控用旁路监测模式。 这是关键。质检规则不对数据入库做任何拦截——数据正常入库,质检任务并行扫描,发现问题后打标记、发告警、生成整改工单,定位到具体表、具体字段、具体记录。比如你发现某张订单表的"客户名称"字段有300条缺失,系统告诉你是哪300条,而不是阻塞整张表不让入库。这种模式既保证了数据流转的效率,又确保了质量问题可发现、可追溯。 质量前置是可选的增强做法。 如果你想更早发现问题,可以在集成前对源端数据做一轮检测——摸清源系统数据的质量底数,有问题的先让源头系统修复再进入中台。这不是必需的步骤,但对数据质量要求高的场景非常有效。 五、实践中怎么落地 江苏某面料贸易企业在做数据集成共享时就采用了这样的思路。这家企业的PLM、ERP、MES、外贸订单、仓储系统各自为政,跨境工厂数据割裂。他们没有追求一步到位,而是先解决核心链路——把订单相关的数据通路打通,同时部署数据标准管理统一字段口径,用质量规则持续监控数据完整性和一致性。系统间数据开始自动流转后,跨境业务协同效率显著提升。 这种做法和康桥数据中台的产品逻辑是一致的:数据通过集成模块归集后,数据质量模块以旁路监测方式对入库数据做质量扫描——不需要改采集链路,质检规则可视化配置,发现问题自动告警。标准管理模块统一数据口径,元数据自动采集构建血缘,资产目录让数据资产可查可用。也可以在数据进中台前,先对源端做一轮质量检测,复核数据质量修复效果。 简单说就是八个字:数据照进,质量并行。 六、常见问题 1. 我们已经有了ETL工具,还需要数据中台的集成能力吗? 工具能搬数据,但不能管数据。中台的价值不在"搬",而在搬完之后——数据质量有没有保障、标准是否统一、血缘能不能追溯。如果只是想先摸清手头数据质量到底怎么样,康桥数据质量管理平台 版免费可用,一行命令部署十来分钟就能跑起来,先做一次数据体检。 2. 异构数据集成的最大成本在哪里? 不是工具采购,是人力和时间。每个新系统的字段映射需要业务人员参与确认语义,这无法自动化。统一数据标准能从根本上降低每次集成的对接成本。 3. 实时集成和批量集成怎么选? 看业务需求。监管报表可以T+1生成,但订单交付状态追踪需要准实时。关键是中台要能同时支持两种模式,而不是二选一。 4. 集成完数据后发现质量不行怎么办? 这正是旁路监测要解决的问题——数据正常入库,质检规则并行扫描,发现问题定位到具体表、具体字段、具体记录。可以打标记、发告警、生成整改工单,而不是简单粗暴地拦截入库。 参考来源 [1] 国家标准化管理委员会,《数据管理能力成熟度评估模型》(GB/T 36073-2025,DCMM 2.0),https://std.samr.gov.cn/gb/search/gbDetailed?id=71F772D82C6CD3A7E05397BE0A0AB82A [2] 国家标准化管理委员会,《信息技术 数据质量评价指标》(GB/T 36344-2018),https://std.samr.gov.cn/gb/search/gbDetailed?id=71F772D82DFCD3A7E05397BE0A0AB82A [3] DAMA International,《DAMA数据管理知识体系指南》(DAMA-DMBOK),https://www.dama.org/learning-resources/dama-data-management-body-of-knowledge-dmbok/
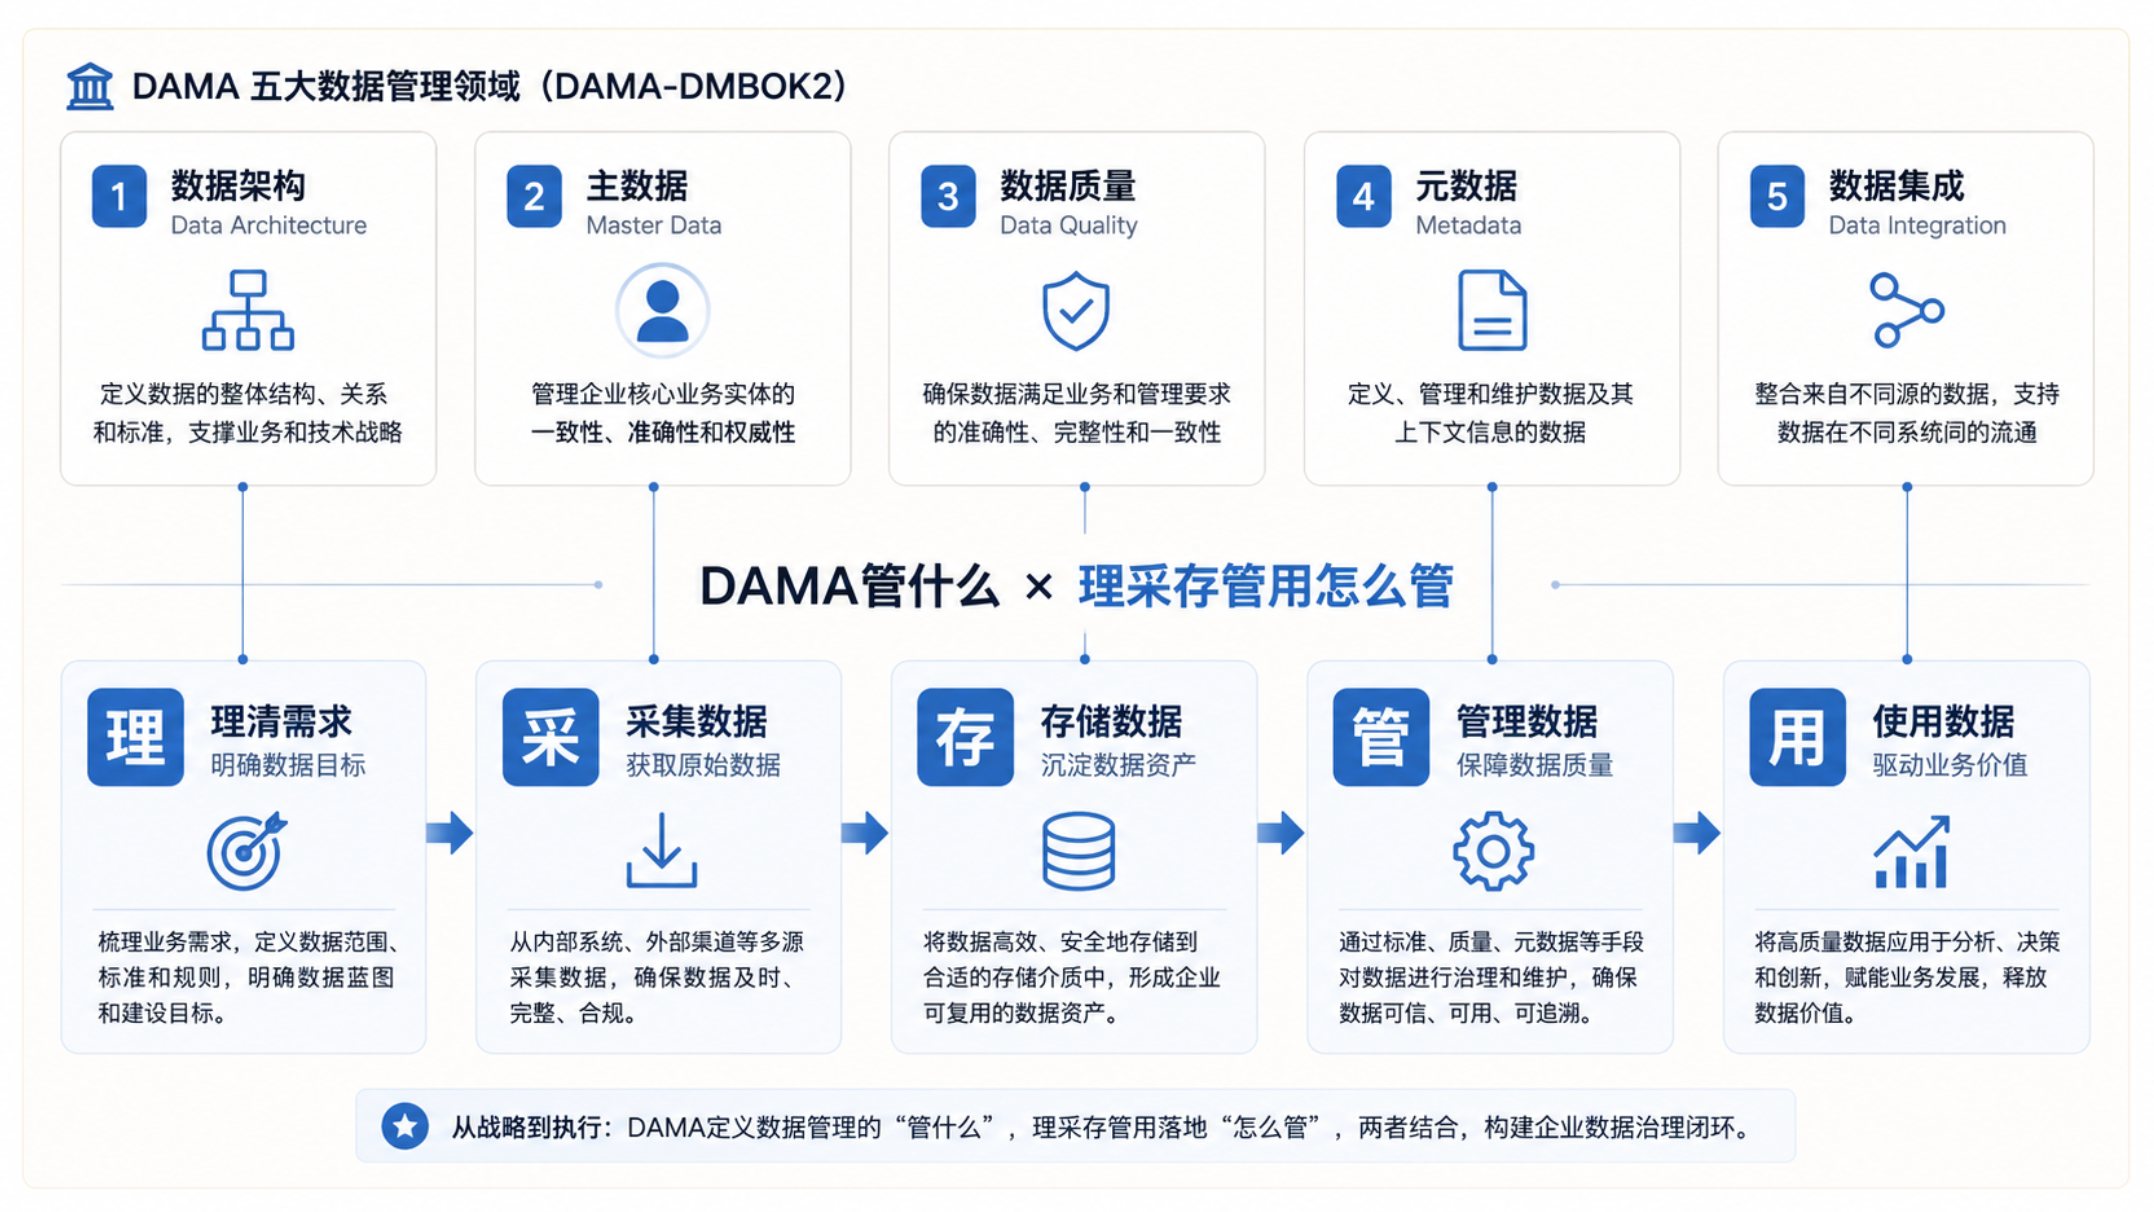
某制造企业投入数百万建设数据中台。ERP、MES、CRM全接进来了,数仓建了,BI也跑起来了。半年后项目复盘,业务部门的使用数据让所有人沉默了——日均活跃用户不到5个。 调查发现不是技术问题。业务人员说得很直接:"同一个客户在三个报表里三个名字,我信哪个?"数据质量问题没有人在入职时就被告知要负责,编码标准没有人在项目启动时参与制定。项目验收了,问题留下了。最终业务部门回归Excel——至少自己填的数自己信。 很多中台项目的失败不是发生在建设阶段,而是发生在上线之后——没有治理的数据平台,和没建之前唯一的区别是:以前数据散在各系统里,现在散在一个更大的系统里。 为什么很多中台项目都卡在这五个地方 复盘下来,大多数项目出问题不是因为技术架构不行,而是五件事没做透。这五件事恰好对应DAMA-DMBOK知识体系(共11个知识领域,详见DAMA International《DAMA-DMBOK 2.0》)中数据中台建设最易出现短板的五个领域: 关键环节 对应DAMA领域 没做透的表现 数据模型没人维护 数据架构 模型在PPT里,实际跑的还是老结构 编码规则没人统一 主数据管理 同一物料三个系统三种叫法 数据问题没人跟进 数据质量 规则配了几十条,告警没人处理 数据资产没人编目 元数据管理 业务想查数,得在群里@IT"帮我找一下" 系统接口没人对口径 数据集成 这边传过去了,那边说格式不对 DAMA把这五个领域系统化为知识框架,不是让你背下来去考试,是让你在项目启动前就知道——这些坑你不填,后面一定踩。 理采存管用 × DAMA:知识框架如何工程化 很多企业理解DAMA时关注的是知识体系,理解数据中台时关注的是技术平台。但项目现场真正需要回答的是:数据应该怎么建设?治理应该如何落地? 康桥数据在大量政企项目实践中发现,DAMA解决的是能力框架问题——告诉你"该管什么";理采存管用解决的是工程路径问题——告诉你"怎么管"。两者是地图和施工图的关系。 理采存管用 对应DAMA领域 中台动作 理 数据战略→数据架构 摸家底、建体系、定蓝图 采 数据架构→数据集成 打通系统、汇聚数据 存 数据架构→数据标准 标准化模型、统一口径 管 数据治理/标准/质量/主数据 元数据+标准落标+质量监控 用 数据应用 资产目录、数据服务、分析报表 真正决定项目成败的往往不是技术选型,而是建设顺序。先治理体系后技术平台,先价值验证后规模推广,先解决业务问题再扩展技术能力——这套思路康桥总结为"理采存管用"建设路径。 四个领域的工程落地 数据架构:模型不在PPT里,要在系统里跑。 某211大学原来的数据模型只存在架构师的文档里,没有人按分层存数据。康桥团队把模型直接落地为ODS-DW-ADS分层架构——模型从设计文档变成运行实体。同步建设数据探查编目系统与数据超市,跨部门数据申请从"天/周级"变成"分钟级"在线自助获取,实现"一站式"数据服务。 主数据管理:同一个东西不能有三种名字。 江苏某建筑装饰集团200余家子公司,同一材料苏州叫"大理石A级",南京叫"A类石材"。围绕物料、供应商、项目建立黄金记录后,跨公司对账从5天缩到1天,数据纠纷减少80%,项目平均工期缩短10%。客户反馈:"以前经营分析会数据全靠各分公司人工报送,真假难辨且滞后严重。现在坐在总部就能看清全国上百个项目的实时成本与合规情况。" 数据质量:配了规则不等于解决了问题。 很多企业质量规则配了几十条,告警堆在那里没人处理。问题不在规则不够,在缺少"发现→定位→修复→验证"的闭环。上海某大型化工企业通过数据中台建设统一物料编码、打通OT与IT数据后,库存周转率提升28%,订单交付及时率提升至91%,报表出具周期提前4天。同步成立数据管理部,将数据治理纳入绩效考核体系,实现从"项目驱动"向"机制驱动"的转变。 元数据管理:别让IT变成人肉数据目录。 化工企业的生产主任从来不看中台——一堆技术表名根本不知道代表什么。康桥通过自动采集+血缘解析形成全企业数据地图后,业务人员在资产门户自己检索,IT团队的数据答疑工作量显著下降。 常见问题 Q:不学DAMA能建好中台吗? 能建,但大概率漏掉关键能力域。DAMA是数据管理的"全景地图",不看地图也能走,容易迷路。 Q:为什么懂DAMA的项目更容易成功? DAMA本质上在回答三个问题:数据归谁负责、按照什么标准管理、出了问题上谁解决。很多中台项目失败不是缺技术,是缺这三个答案。技术平台解决流动问题,治理解决可信问题,两者结合数据才转化为业务价值。 Q:理采存管用和DAMA冲突吗? 不冲突。DAMA是知识框架,理采存管用是工程路径。一个是地图,一个是施工图。 Q:DCMM和DAMA是什么关系? DCMM(GB/T 36073-2018《数据管理能力成熟度评估模型》,2025版DCMM 2.0将于2026年7月施行)是中国在数据管理领域首个国家标准,划分八大能力域(数据战略/治理/架构/标准/质量/安全/应用/生存周期)和五级成熟度(初始→受管理→稳健→量化管理→优化级);DAMA是国际数据管理协会发布的《DAMA-DMBOK数据管理知识体系指南》(最新为2.0修订版,共11个知识领域)。DCMM评估"你做到了什么程度",DAMA回答"你应该做什么"。 企业建数据中台,真正需要回答的不是"用什么技术栈",而是"数据管理能力建设到了什么程度"。DAMA-DMBOK给出了全景地图(11个知识领域),DCMM(GB/T 36073-2018)给出了评估标准(八大能力域、五级成熟度),康桥数据理采存管用给出了工程落地路径。地图决定方向,标准决定高度,路径决定结果。 参考资料: 1.DAMA International. DAMA-DMBOK: Data Management Body of Knowledge (2nd Edition, Revised). 11个知识领域涵盖数据治理、数据架构、数据建模与设计、数据存储与操作、数据安全、数据集成与互操作、文档与内容管理、参考数据与主数据、数据仓库与商务智能、元数据管理、数据质量。 2.GB/T 36073-2018《数据管理能力成熟度评估模型》(DCMM),我国首个数据管理领域国家标准,八大能力域、五级成熟度。DCMM 2.0(GB/T 36073-2025)将于2026年7月1日起施行,能力域扩展至九个。 3.案例数据来源:康桥数据官网案例库(longshidata.com/cases),含上海某大型化工企业、江苏某建筑装饰集团、江苏某211大学等真实项目数据。
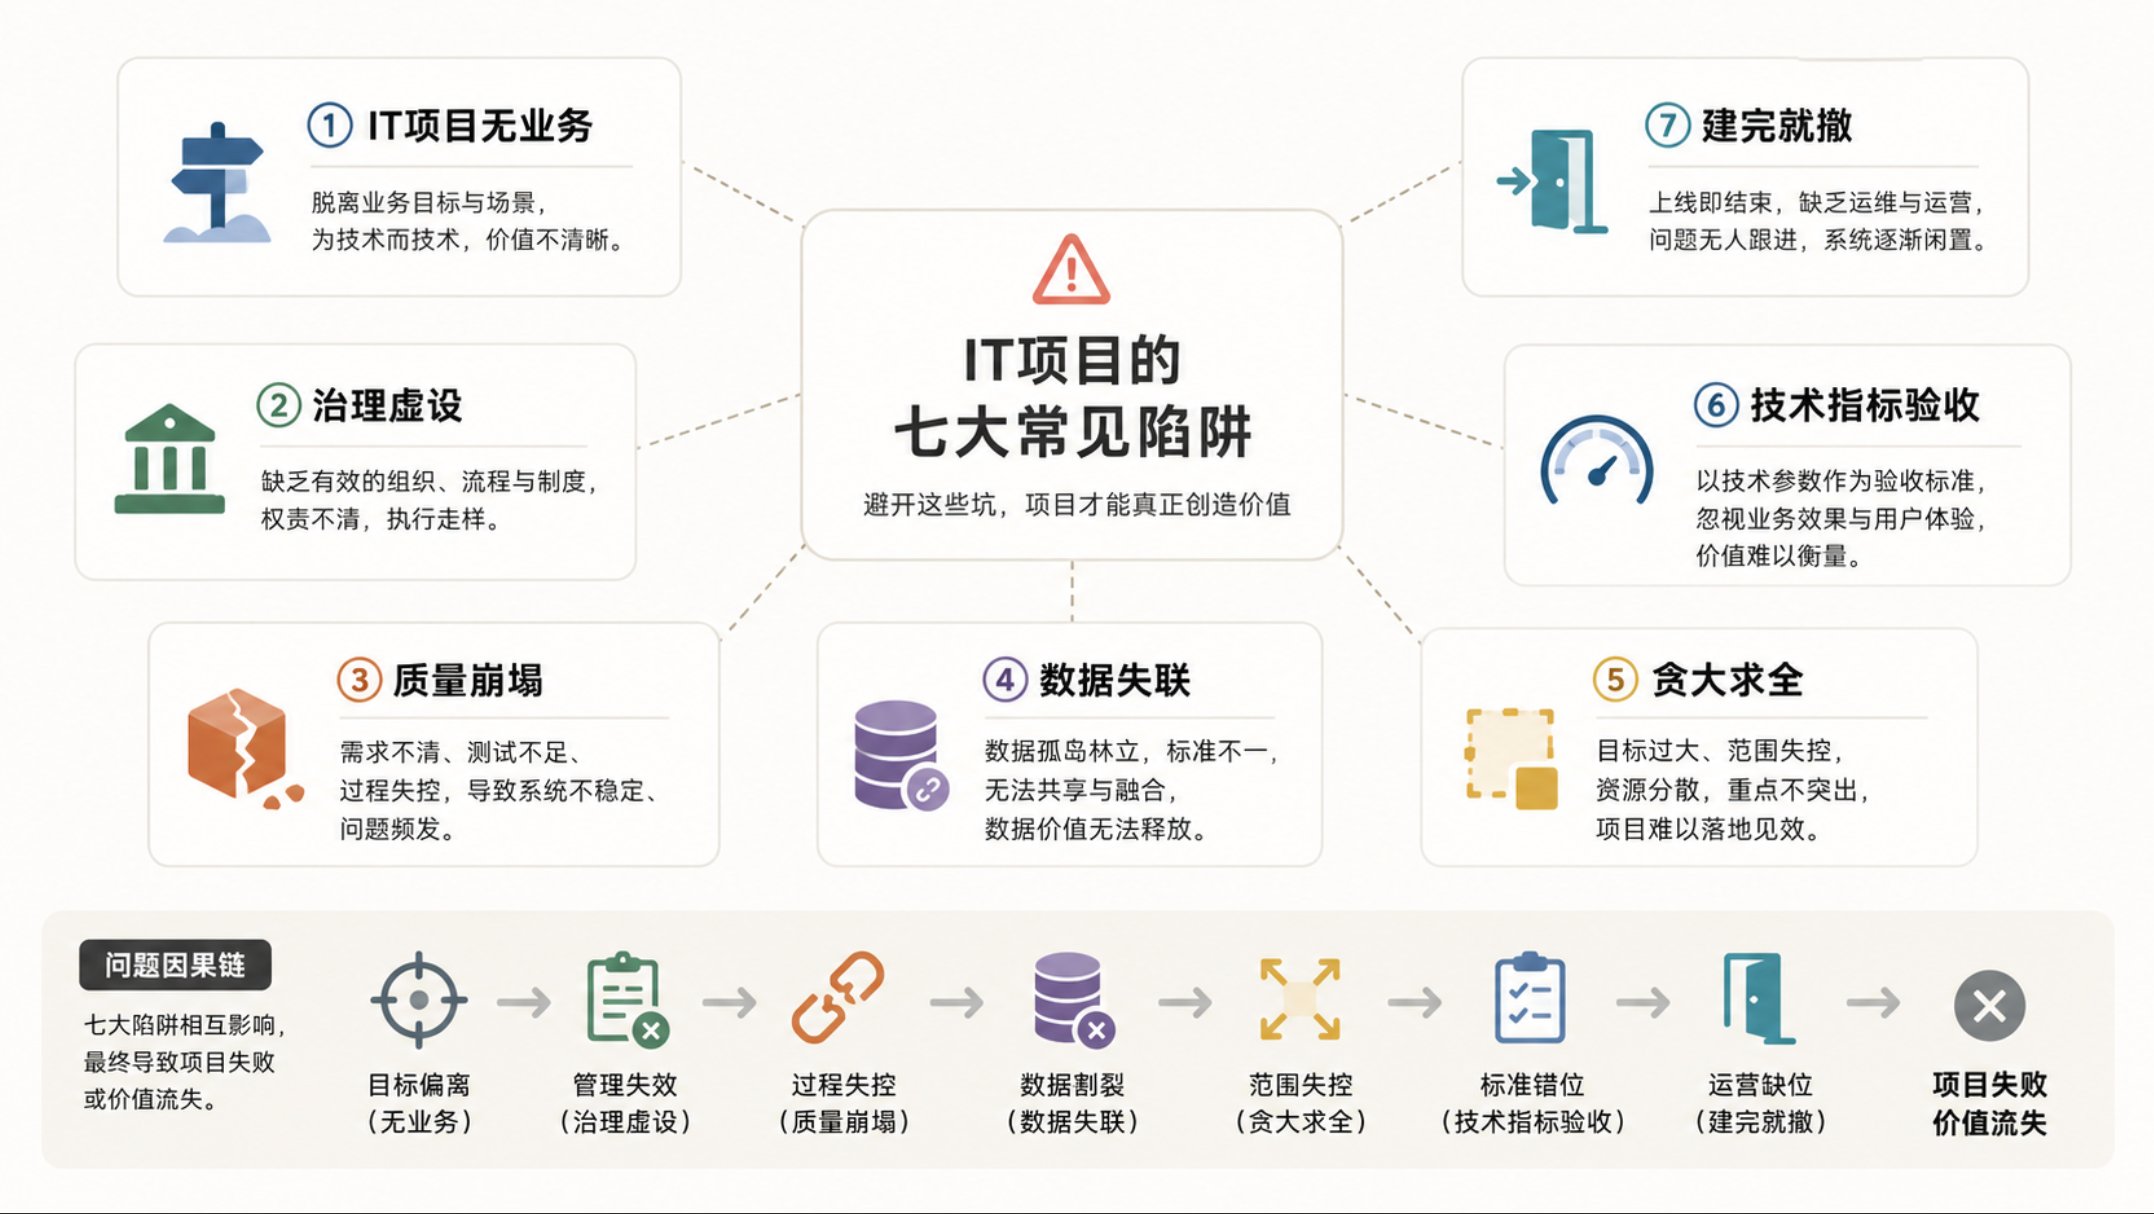
中台不是数字化建设的终点。它是企业从有数据走向用数据的起点。
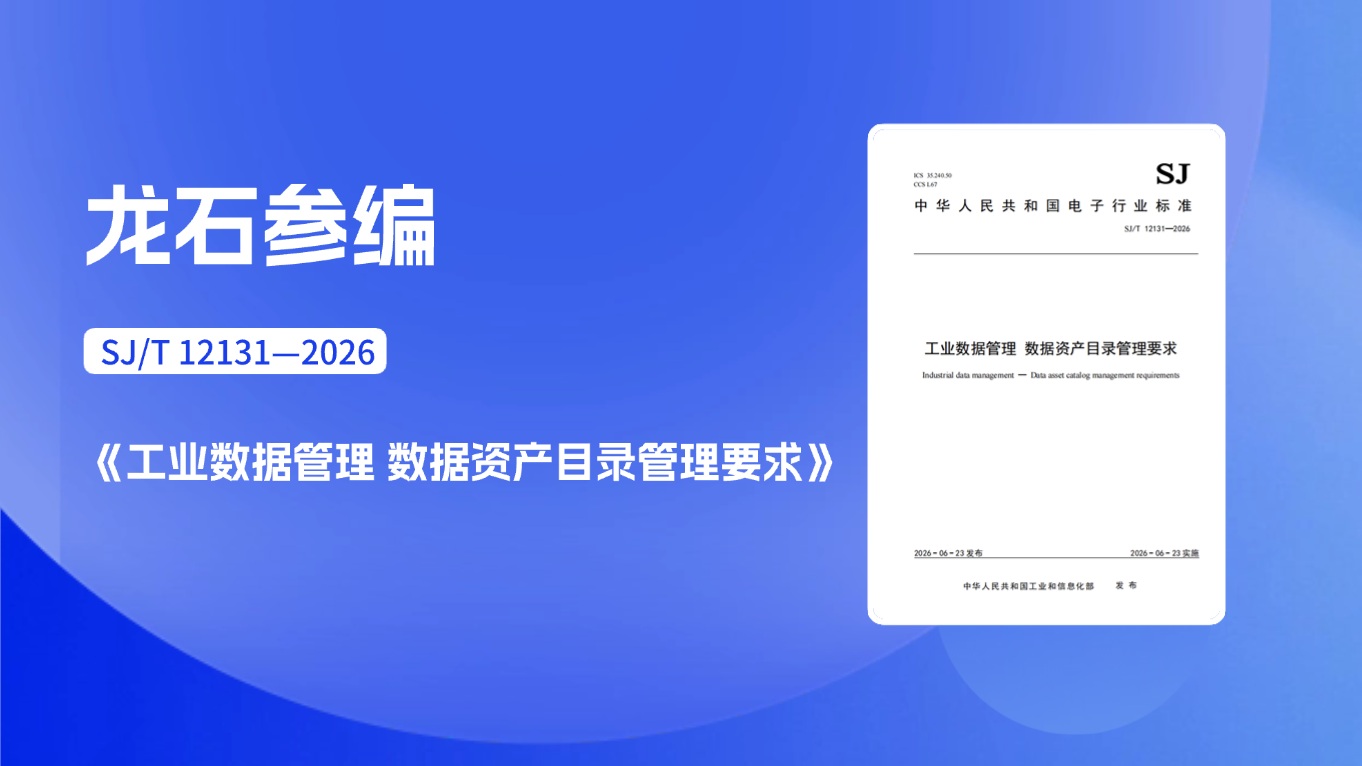
康桥数据为本标准起草单位之一,公司解决方案总监孙晓宁全程参与编制,从需求调研、体系搭建到多轮研讨、条文修订,将一线数据治理实践经验融入标准内容。
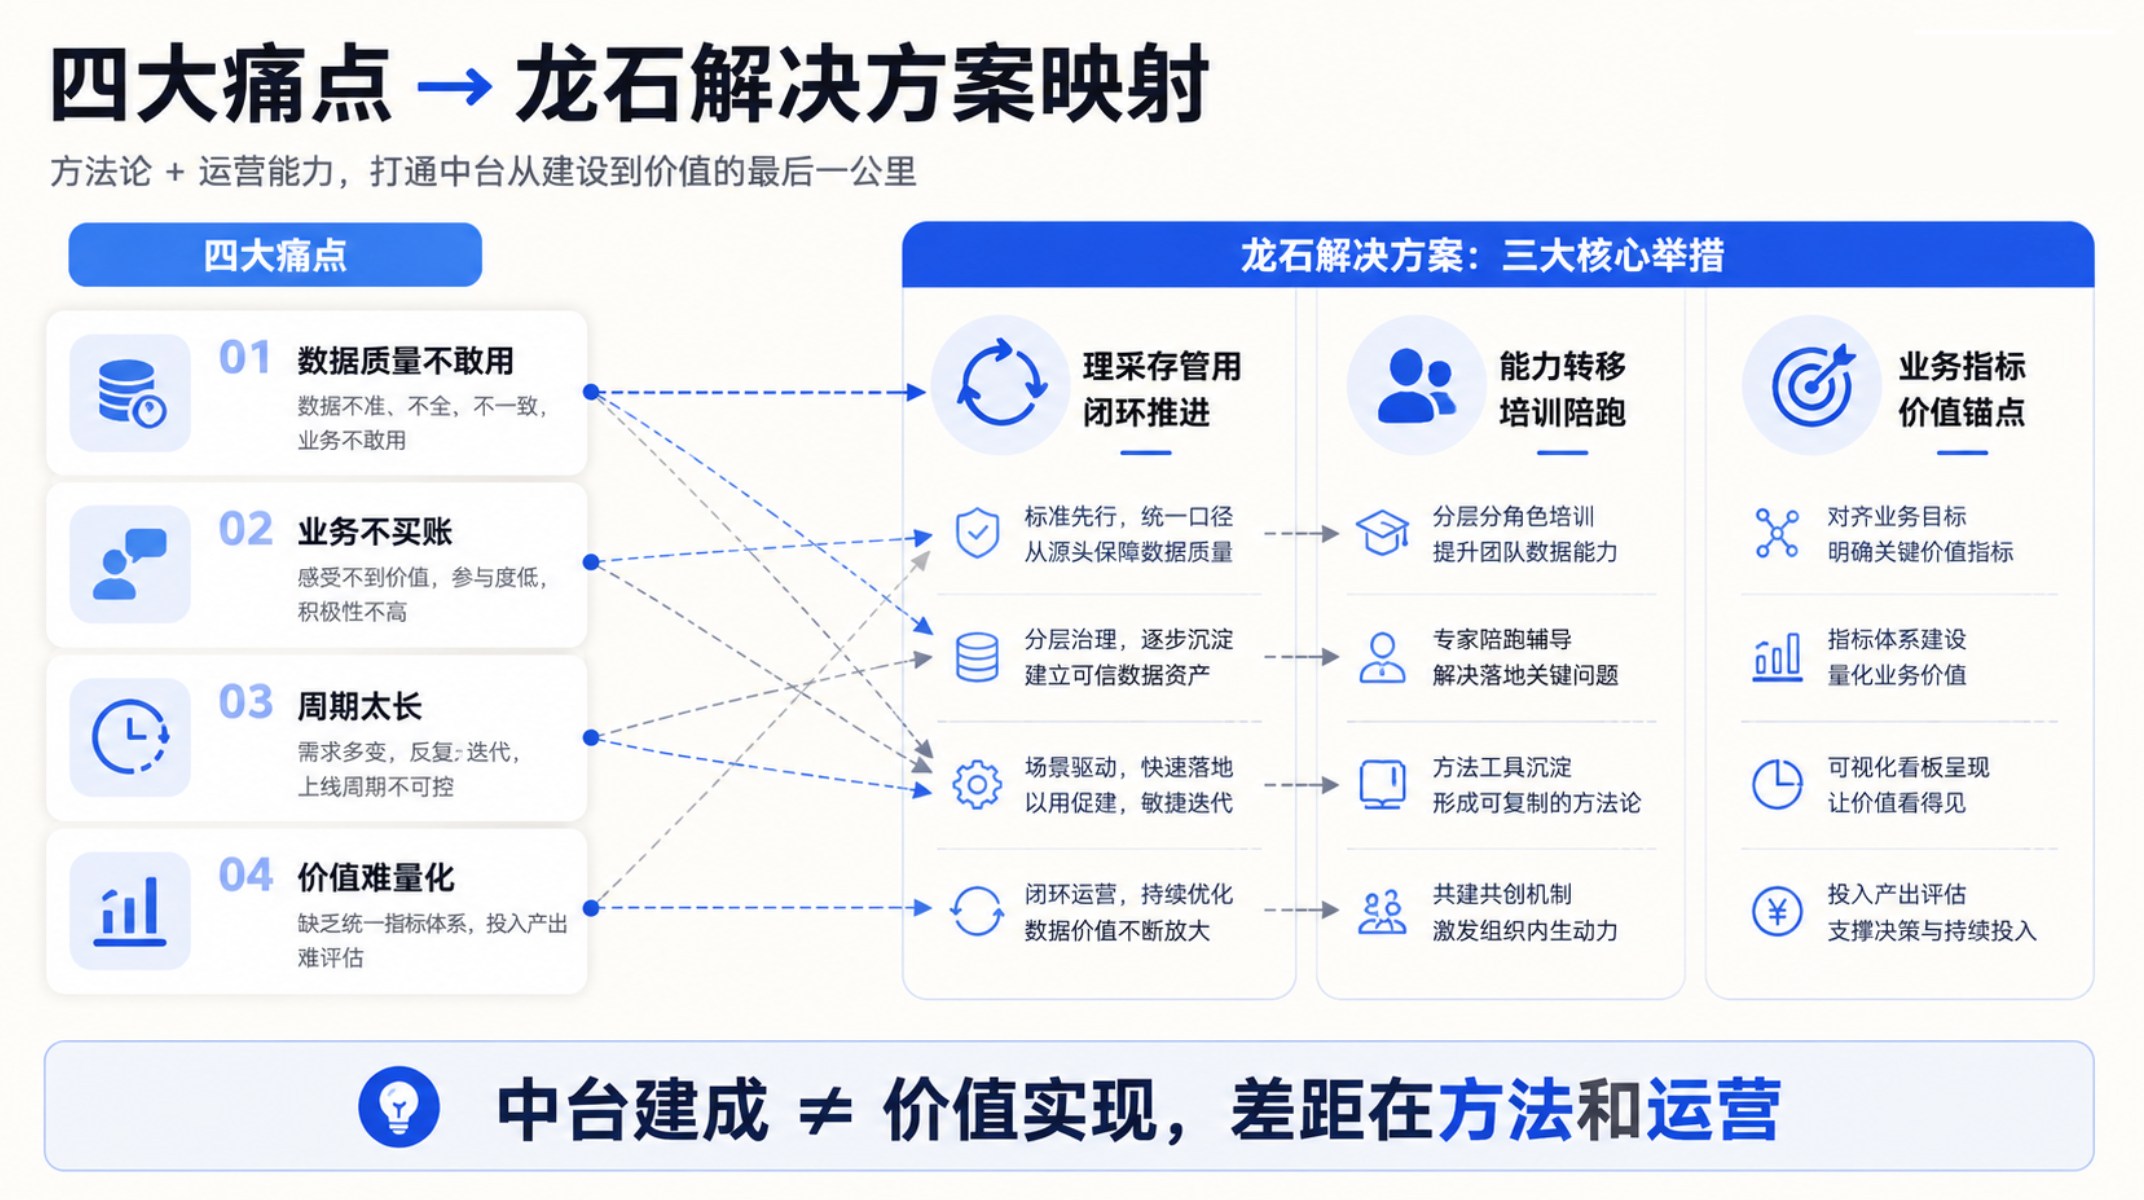
"中台项目投了 500 万,ROI 在哪?" 这是今年被问到最多的问题。Gartner 的数据更让人睡不着:超过 60% 的数据中台项目未能达到预期目标[1]。数据接进来了、大屏跑起来了、报表也出了。但老板问一句"值不值",CDO 回答不上来。 不是项目没做,是做了没算账。投入产出比低,本质是四个核心痛点没解决。康桥数据在服务政企客户的过程中,反复验证了这四个痛点的杀伤力——以及解法。 痛点一:数据质量不敢用。 低质量数据每年给企业造成平均 1290 万美元的损失[2]。这不是技术问题,是财务问题。数据接进来了,但业务部门打开一看——手机号是空的、客户名三种写法、同一个指标三个口径。谁敢用? 康桥在某化工企业的项目里,上线第一步就是建立质量监测机制。在集成环节配置完整性检查和准确性校验规则,数据入库时自动校验,不合规的打回源系统修正。项目上线后,核心数据的质量合规率从不到 60% 提升到 95% 以上。质量有保障了,业务部门才敢把数据用到经营分析里。 痛点二:业务部门不买账。 Gartner 预测,到 2027 年,80% 的数据治理项目将因缺乏业务驱动力而失败[3]。中台做了大半年,业务部门还是自己导出 Excel——不是平台不好用,是他们根本不知道平台能帮他们做什么。 康桥的做法不是在项目初期要求业务部门"配合治理",而是先帮他们解决一个具体的痛点。某建筑装饰集团的 CDO 在康桥建议下,成立数据治理委员会,由业务副总裁挂帅、IT 负责执行。先把采购、库存两个核心域的治理做透,业务部门第一周就看到了准确的数据报表。半年后平台使用率翻了三倍。 痛点三:建设周期太长不出成果。 动辄 12-18 个月的交付周期,半年不出成果老板就没了耐心。很多团队一上来就想覆盖所有系统,越做越大、越做越慢。艾瑞咨询的数据中台行业报告指出,"重投入、低成效"是行业核心困境[4]。 康桥的方法是"理采存管用"闭环推进——不串行等待,而是选一个核心业务域快速打透。理完资产就能看目录,采完数据就能出报表,管好质量就能建立信任。某 211 大学按这个节奏推进,教务和学生两个域 3 个月就看到效果——跨部门数据申请从"天/周级"缩短到"分钟级"。 痛点四:价值无法量化。 "提升了数据能力""支撑了数字化转型"——这些目标无法验证。没有一个业务数字是因为中台改善的,中台就永远是成本项。信通院的研究表明,数字化投入每提升 1%,成本费用利润率提高 6.71%[5]——但前提是"业务真正在用"。 康桥在项目中从第一天就建立价值锚点:不是汇报接了多少系统、建了多少模型,而是汇报"客户响应速度提升了多少""人工对账时间缩短了多久""库存周转加快了几天"。上海市某化工企业的预测性维护项目,把设备运行数据和工艺参数结合后,非计划停机减少了 37%——这个数字,老板听懂了。 四个痛点的根因是同一个:中台建成 ≠ 价值实现。 但为什么有些中台项目能做出 ROI,有些做不出来?差距不在产品功能上——数据集成、数据治理、数据质量这些模块,主流中台厂商基本都有。真正的差距在建设方法和运营思路上。 第一,理采存管用不是产品模块划分,是价值落地路径。 很多团队把中台建设理解成"先理完、再采完、再存完"的串行工程,等所有步骤走完才让业务部门用。但康桥在大量项目中验证的经验是:理采存管用应该是一个闭环——每个阶段都有业务产出。理完一个核心域,业务人员就能通过资产目录看到自己有什么数据;采完第一批高价值系统,就能出第一张业务报表;管好一个核心指标的质量,业务部门就开始建立信任。 企业不需要等项目全部结束才能看到成果。每完成一个阶段就产生一次业务价值——这是 ROI 提升的关键。 第二,中台项目的问题往往不是不会建设,而是不会运营。 很多中台上线之后就没有然后了——元数据没人维护了、质量标准没人更新了、业务部门的问题没人响应了。康桥的答案是能力转移:项目交付不是终点,而是客户自主运营的起点。 具体做法是三层培训和三步陪跑。理论培训帮团队建立 DCMM、DAMA 等标准的共同语言;实施培训让团队掌握项目推进和持续运营的方法;实战培训手把手带团队完成全流程实操。陪跑阶段从集中培训到样板工程建设再到远程技术支撑——不是替客户做治理,而是帮客户建立自己持续做治理的能力。项目结束后,客户团队能自主推进数据标准迭代、质量规则优化和资产目录更新。 第三,让业务部门主动用起来,比任何技术指标都重要。 康桥项目的价值衡量标准不是接了多少系统、建了多少模型,而是业务部门是否在主动使用数据、是否有业务指标因为中台而改善。数据质量合规率、业务自助申请率、核心指标修复周期——这些才是真正该看的数字。当客户能说出"这个数据帮我们减少了几天对账时间""那个指标帮我们提前发现了供应链风险",ROI 就不再是 PPT 上的估算,而是每个季度都能回顾的真实成果。 常见问题 Q:中台 ROI 怎么算? 不要追求精确的财务数字。先找一个业务域,看中台带来的改变能不能用业务指标描述——时间缩短了多少、成本降低了多少。有至少一个能说的数字,ROI 就有了起点。 Q:业务部门不配合怎么办? 不要用治理规范去要求,用业务价值去吸引。帮他们解决一个具体痛点——数据找不到、报表太慢——他们自然就来了。 Q:怎么让老板看到价值? 不要让老板看技术指标,让老板看业务数字。建立"中台价值看板",每月呈现数据调用量、支撑业务场景数、每个场景的可量化收益。 参考来源 [1] Gartner, "Over 100 Data, Analytics and AI Predictions Through 2030," June 2024 [2] Gartner, "Data Quality: Why It Matters and How to Achieve It," 2020 [3] Gartner, "Gartner Data & Analytics Summit 2024 — Top D&A Predictions," 2024 [4] 艾瑞咨询,《2024年中国数据中台行业研究报告》,2024年7月 [5] 中国信息通信研究院,《中国数字经济发展研究报告(2025年)》,2026年3月
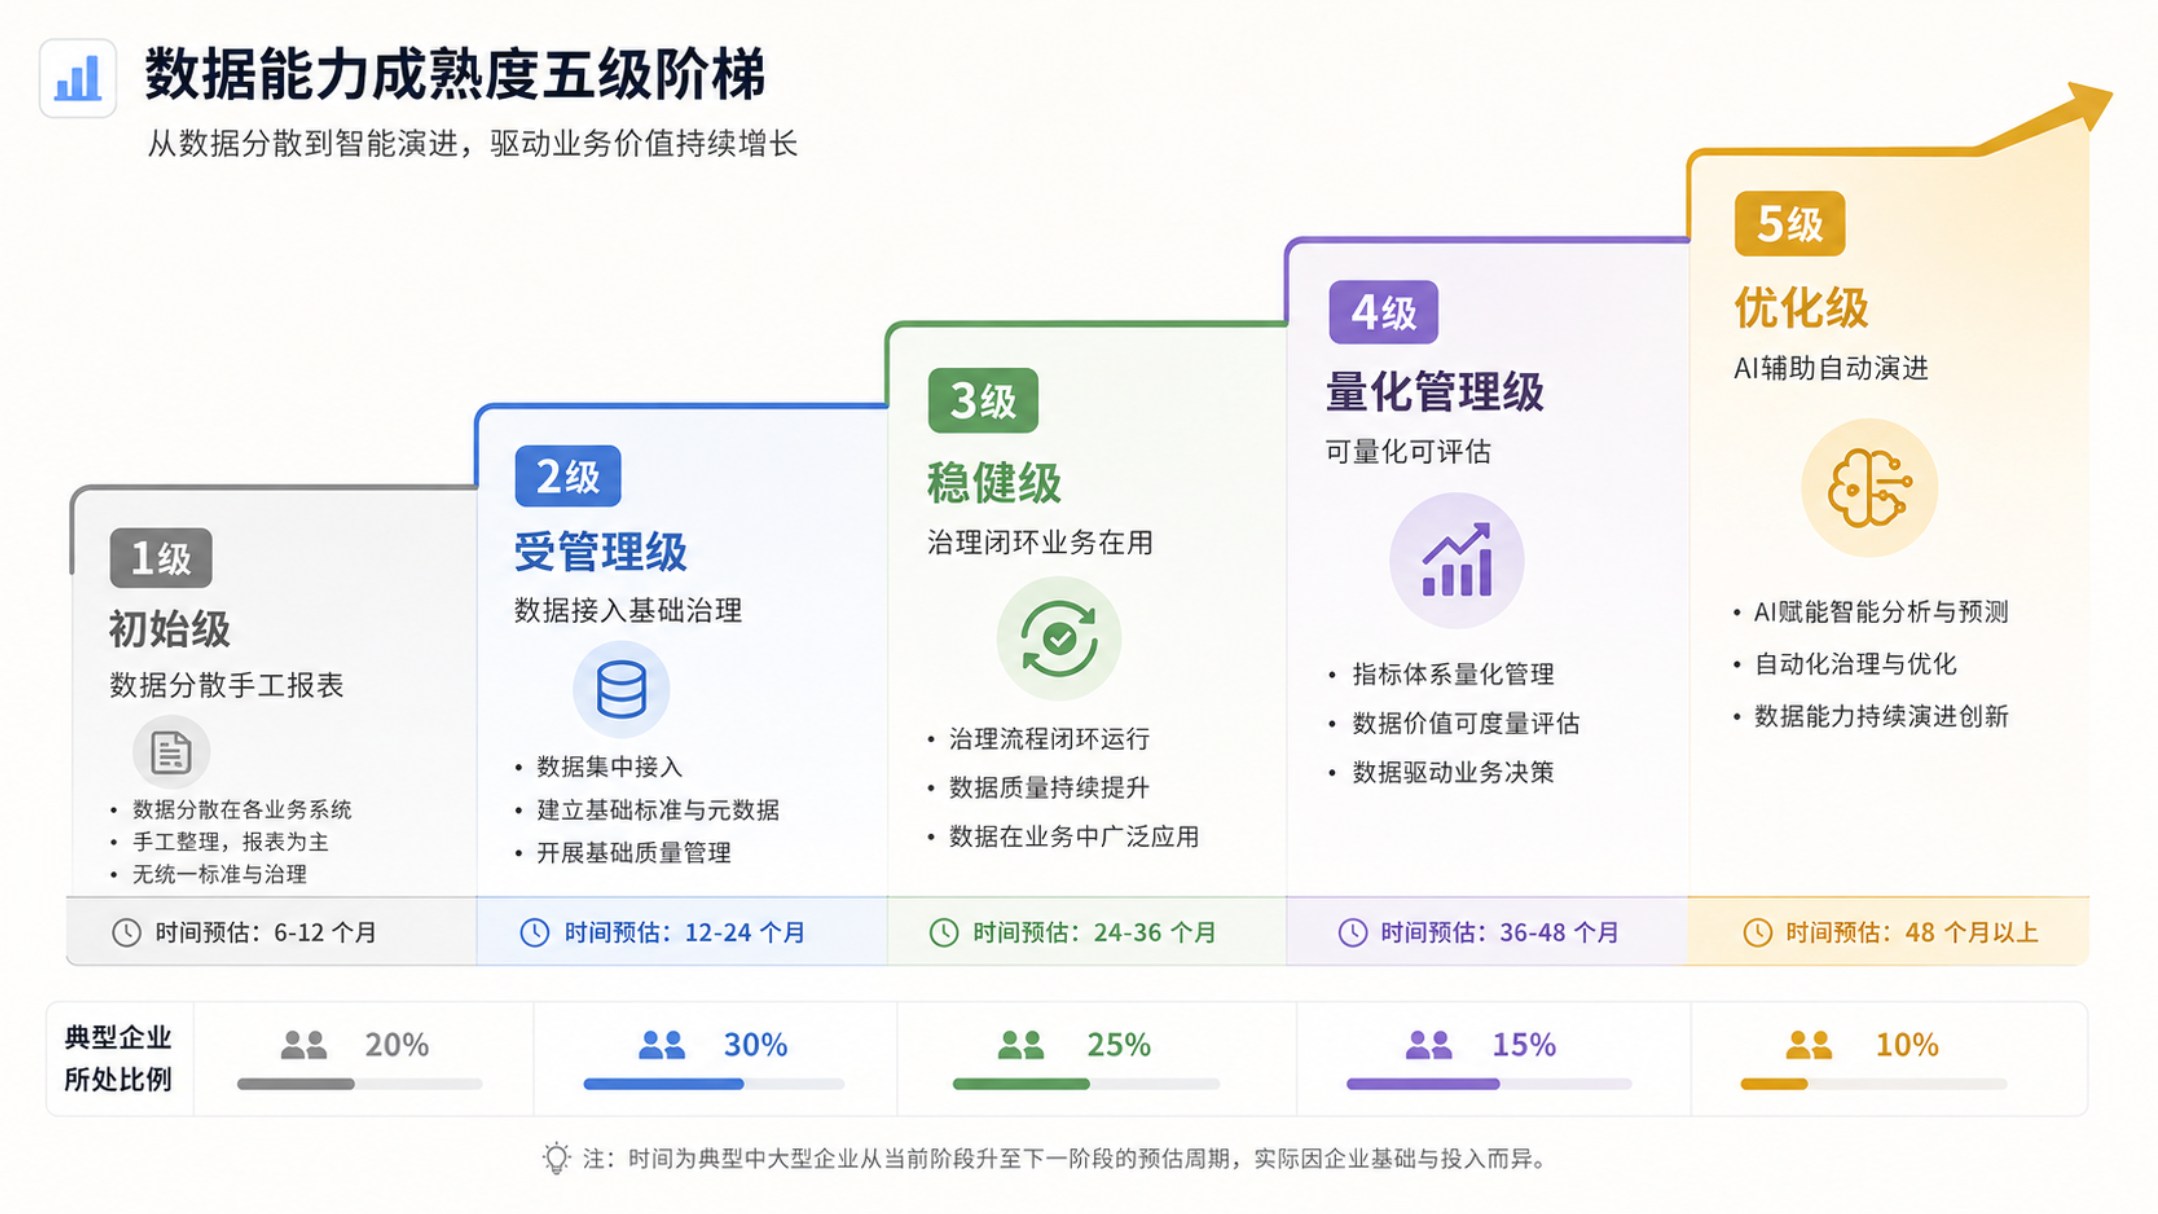
DCMM 2.0 即将实施的窗口期,每一个正在建设或已经建成数据中台的企业,都值得用 DCMM 的框架重新审视自己的建设思路——你建的到底是平台,还是能力?企业未来竞争的核心,不是拥有多少数据,而是能否把数据变成持续创造价值的资产。
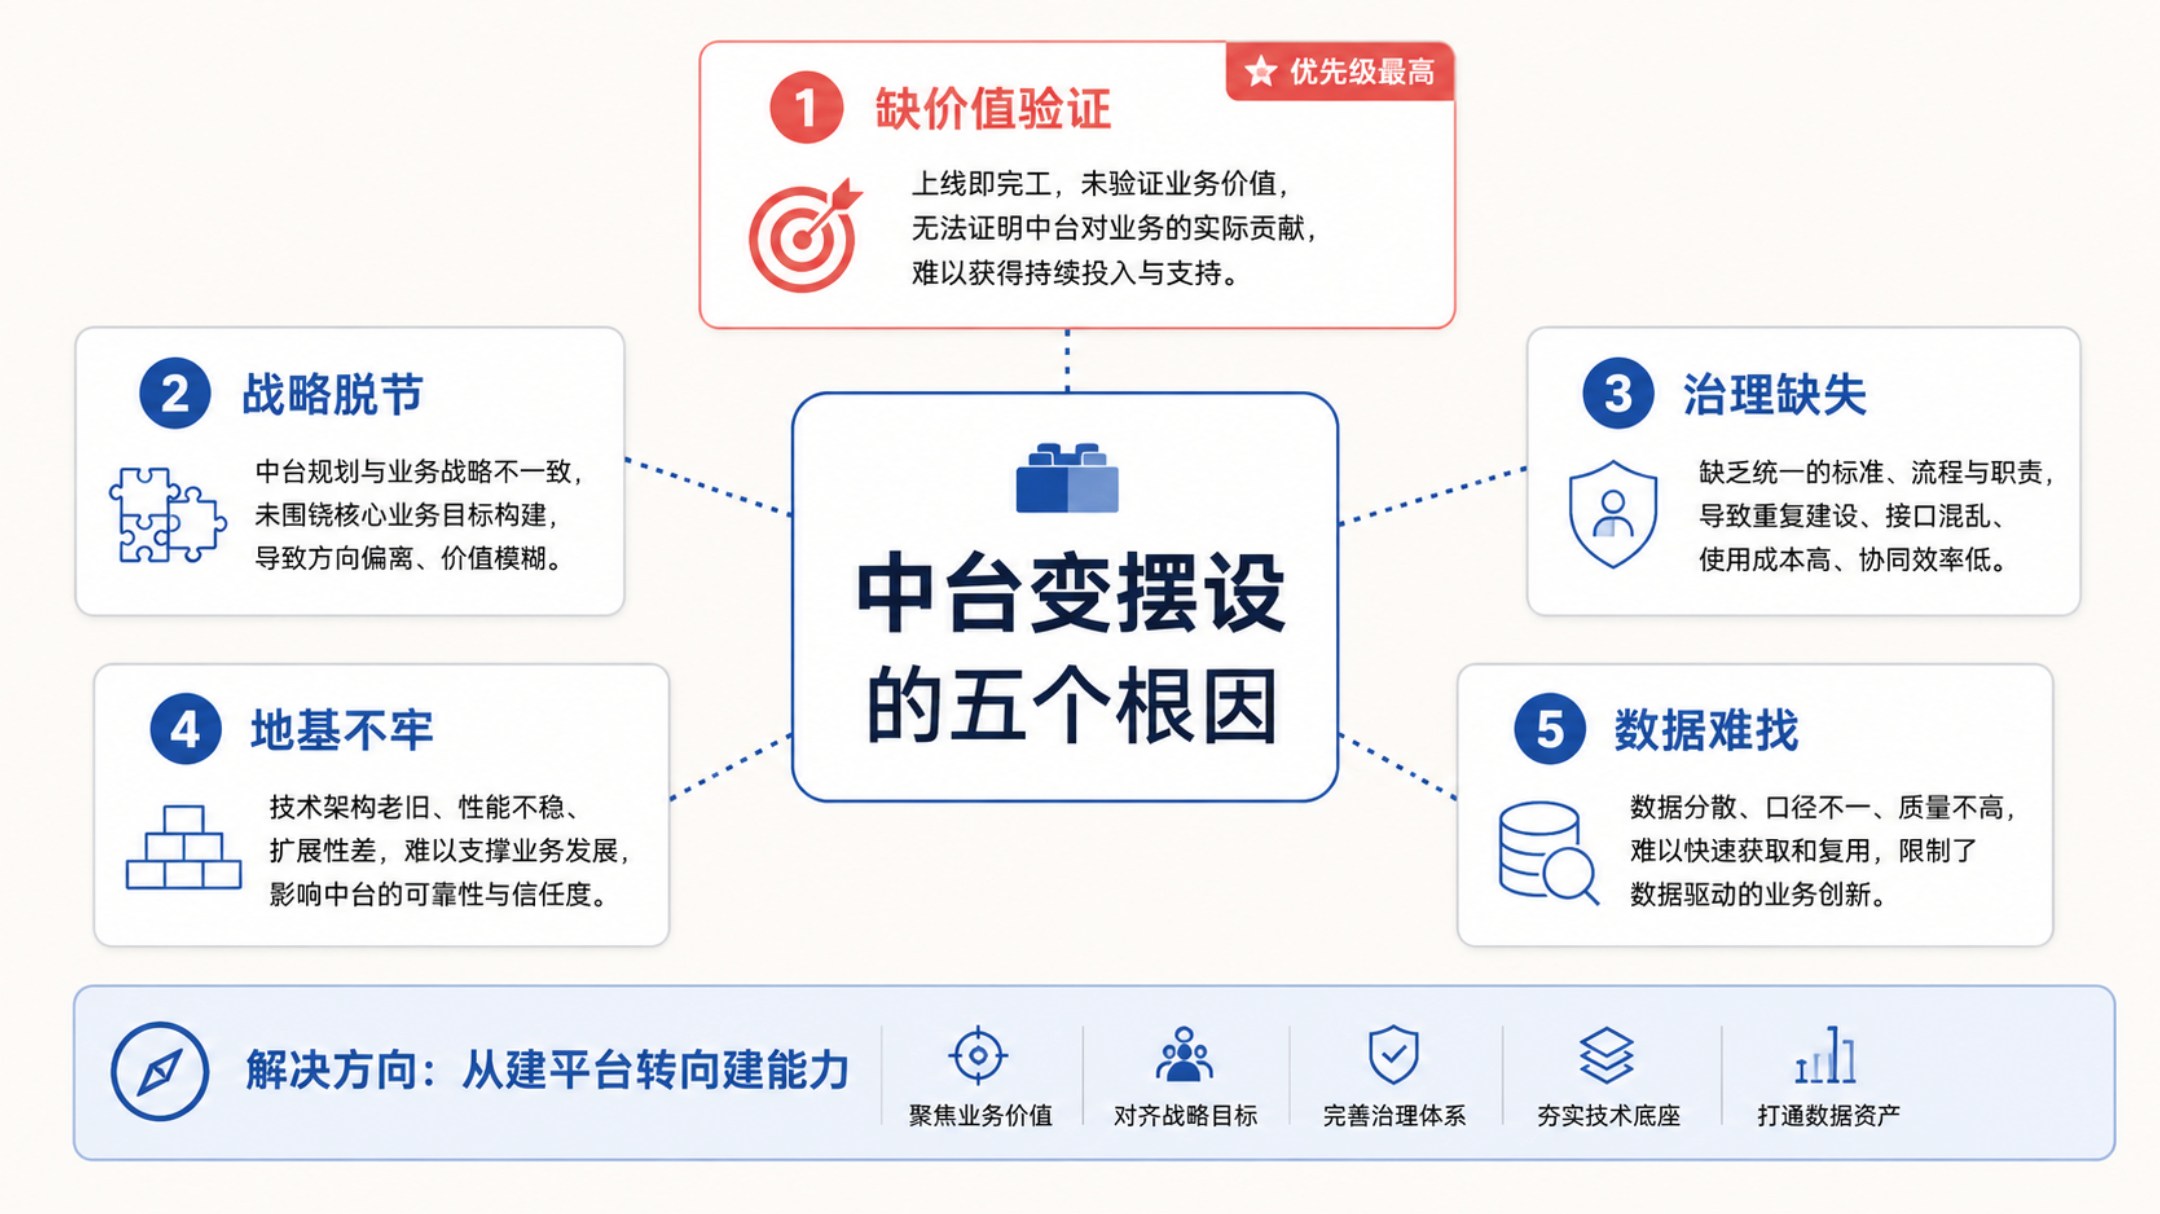
失败的数据中台,真正的问题往往不在技术,而在于它们从来没有真正进入过业务流程。数据只有被使用,才能产生价值;价值被验证,才能形成投入;持续投入,才能形成能力。数据中台最终比拼的,不是谁接入的系统更多,而是谁更快把数据转化成业务成果。
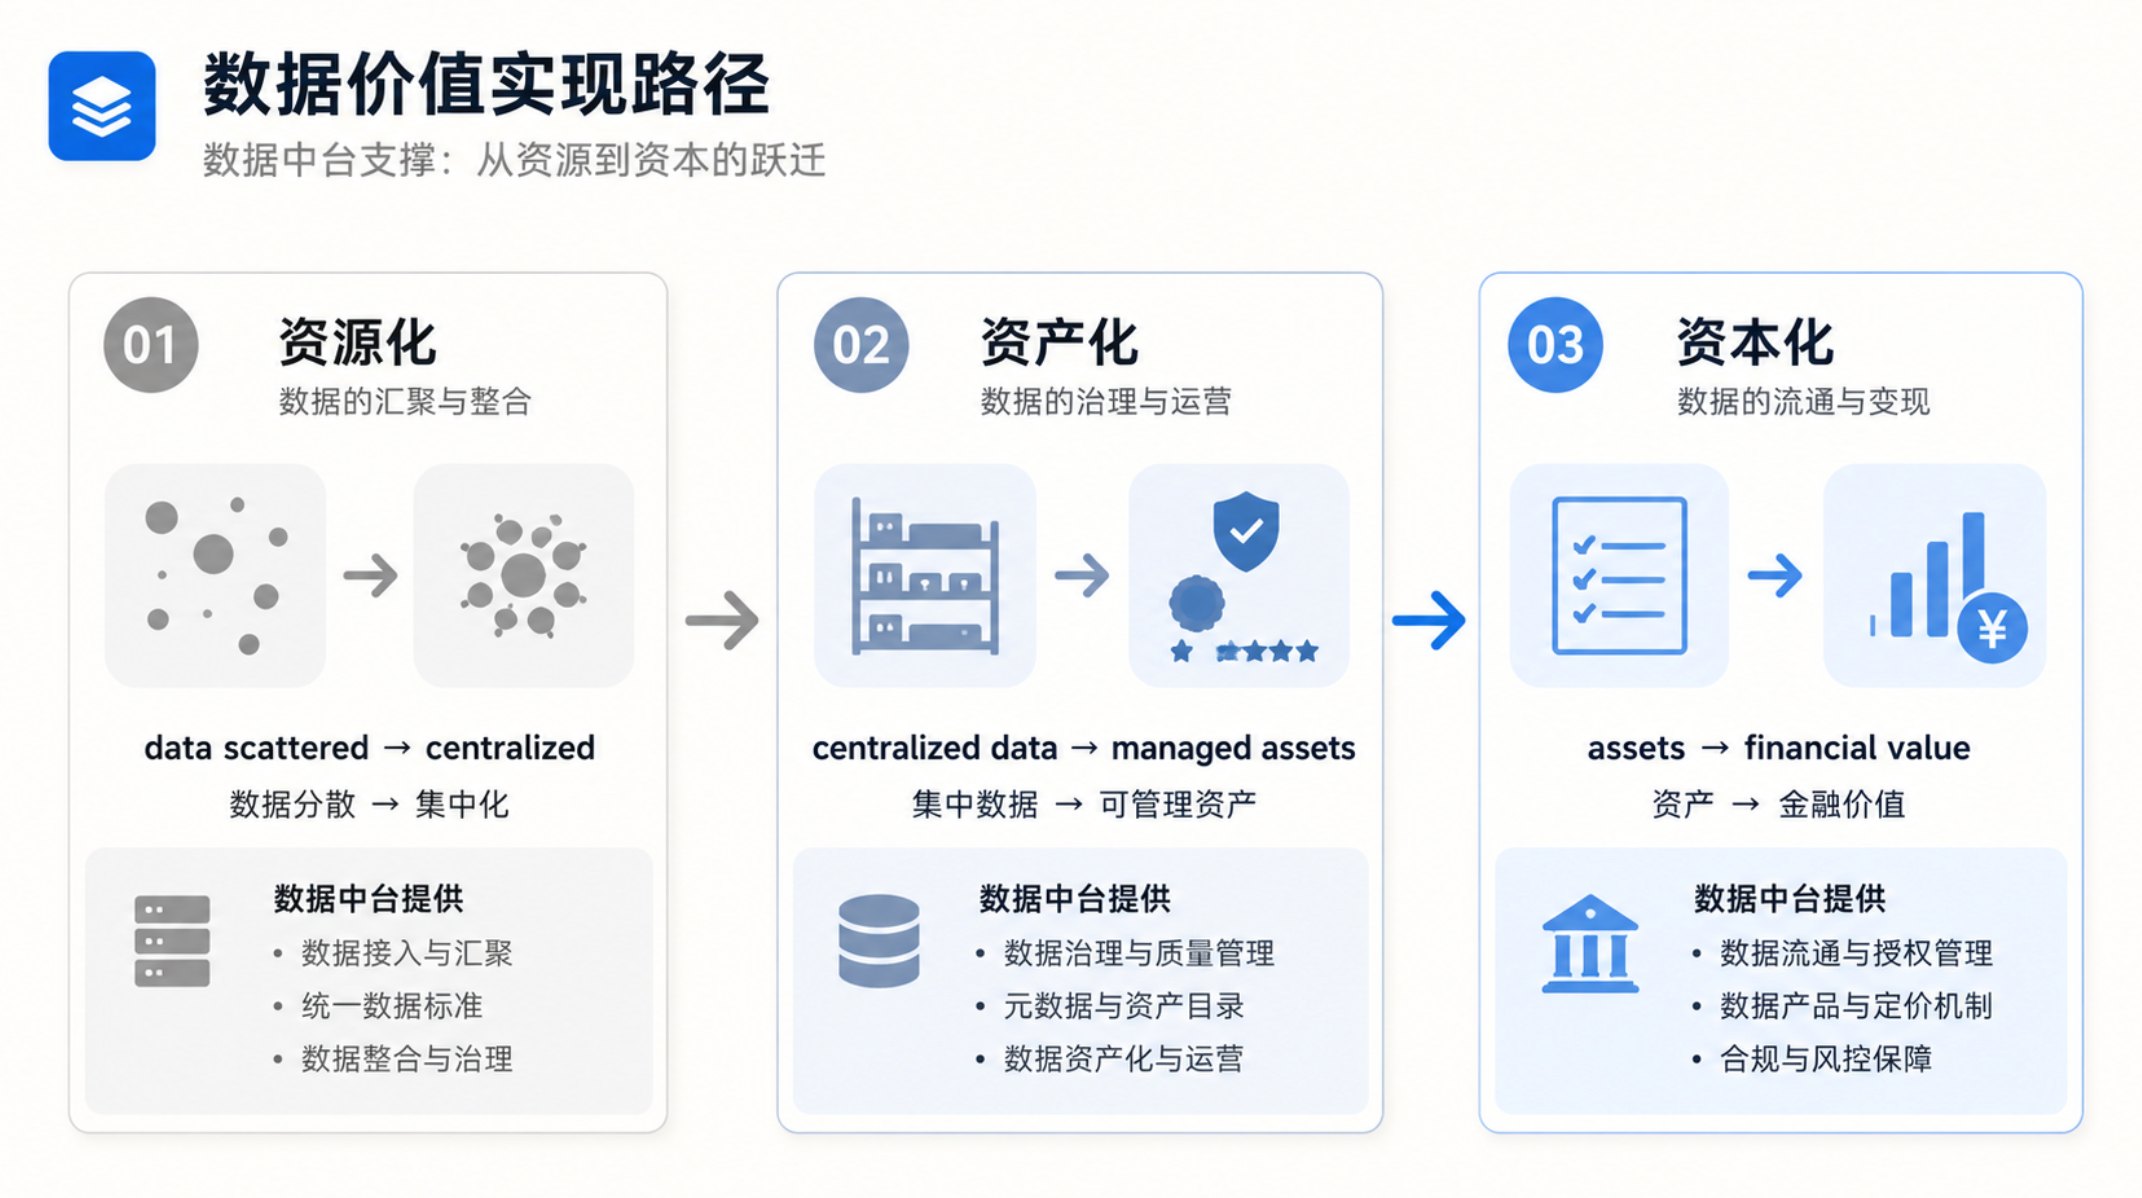
数据要素市场化只是起点。谁能率先建立资源化→资产化→价值化的闭环,谁就更有机会把数据真正转化为生产力。数据中台不再只是技术平台——它是企业数据资产运营体系的核心基础设施。
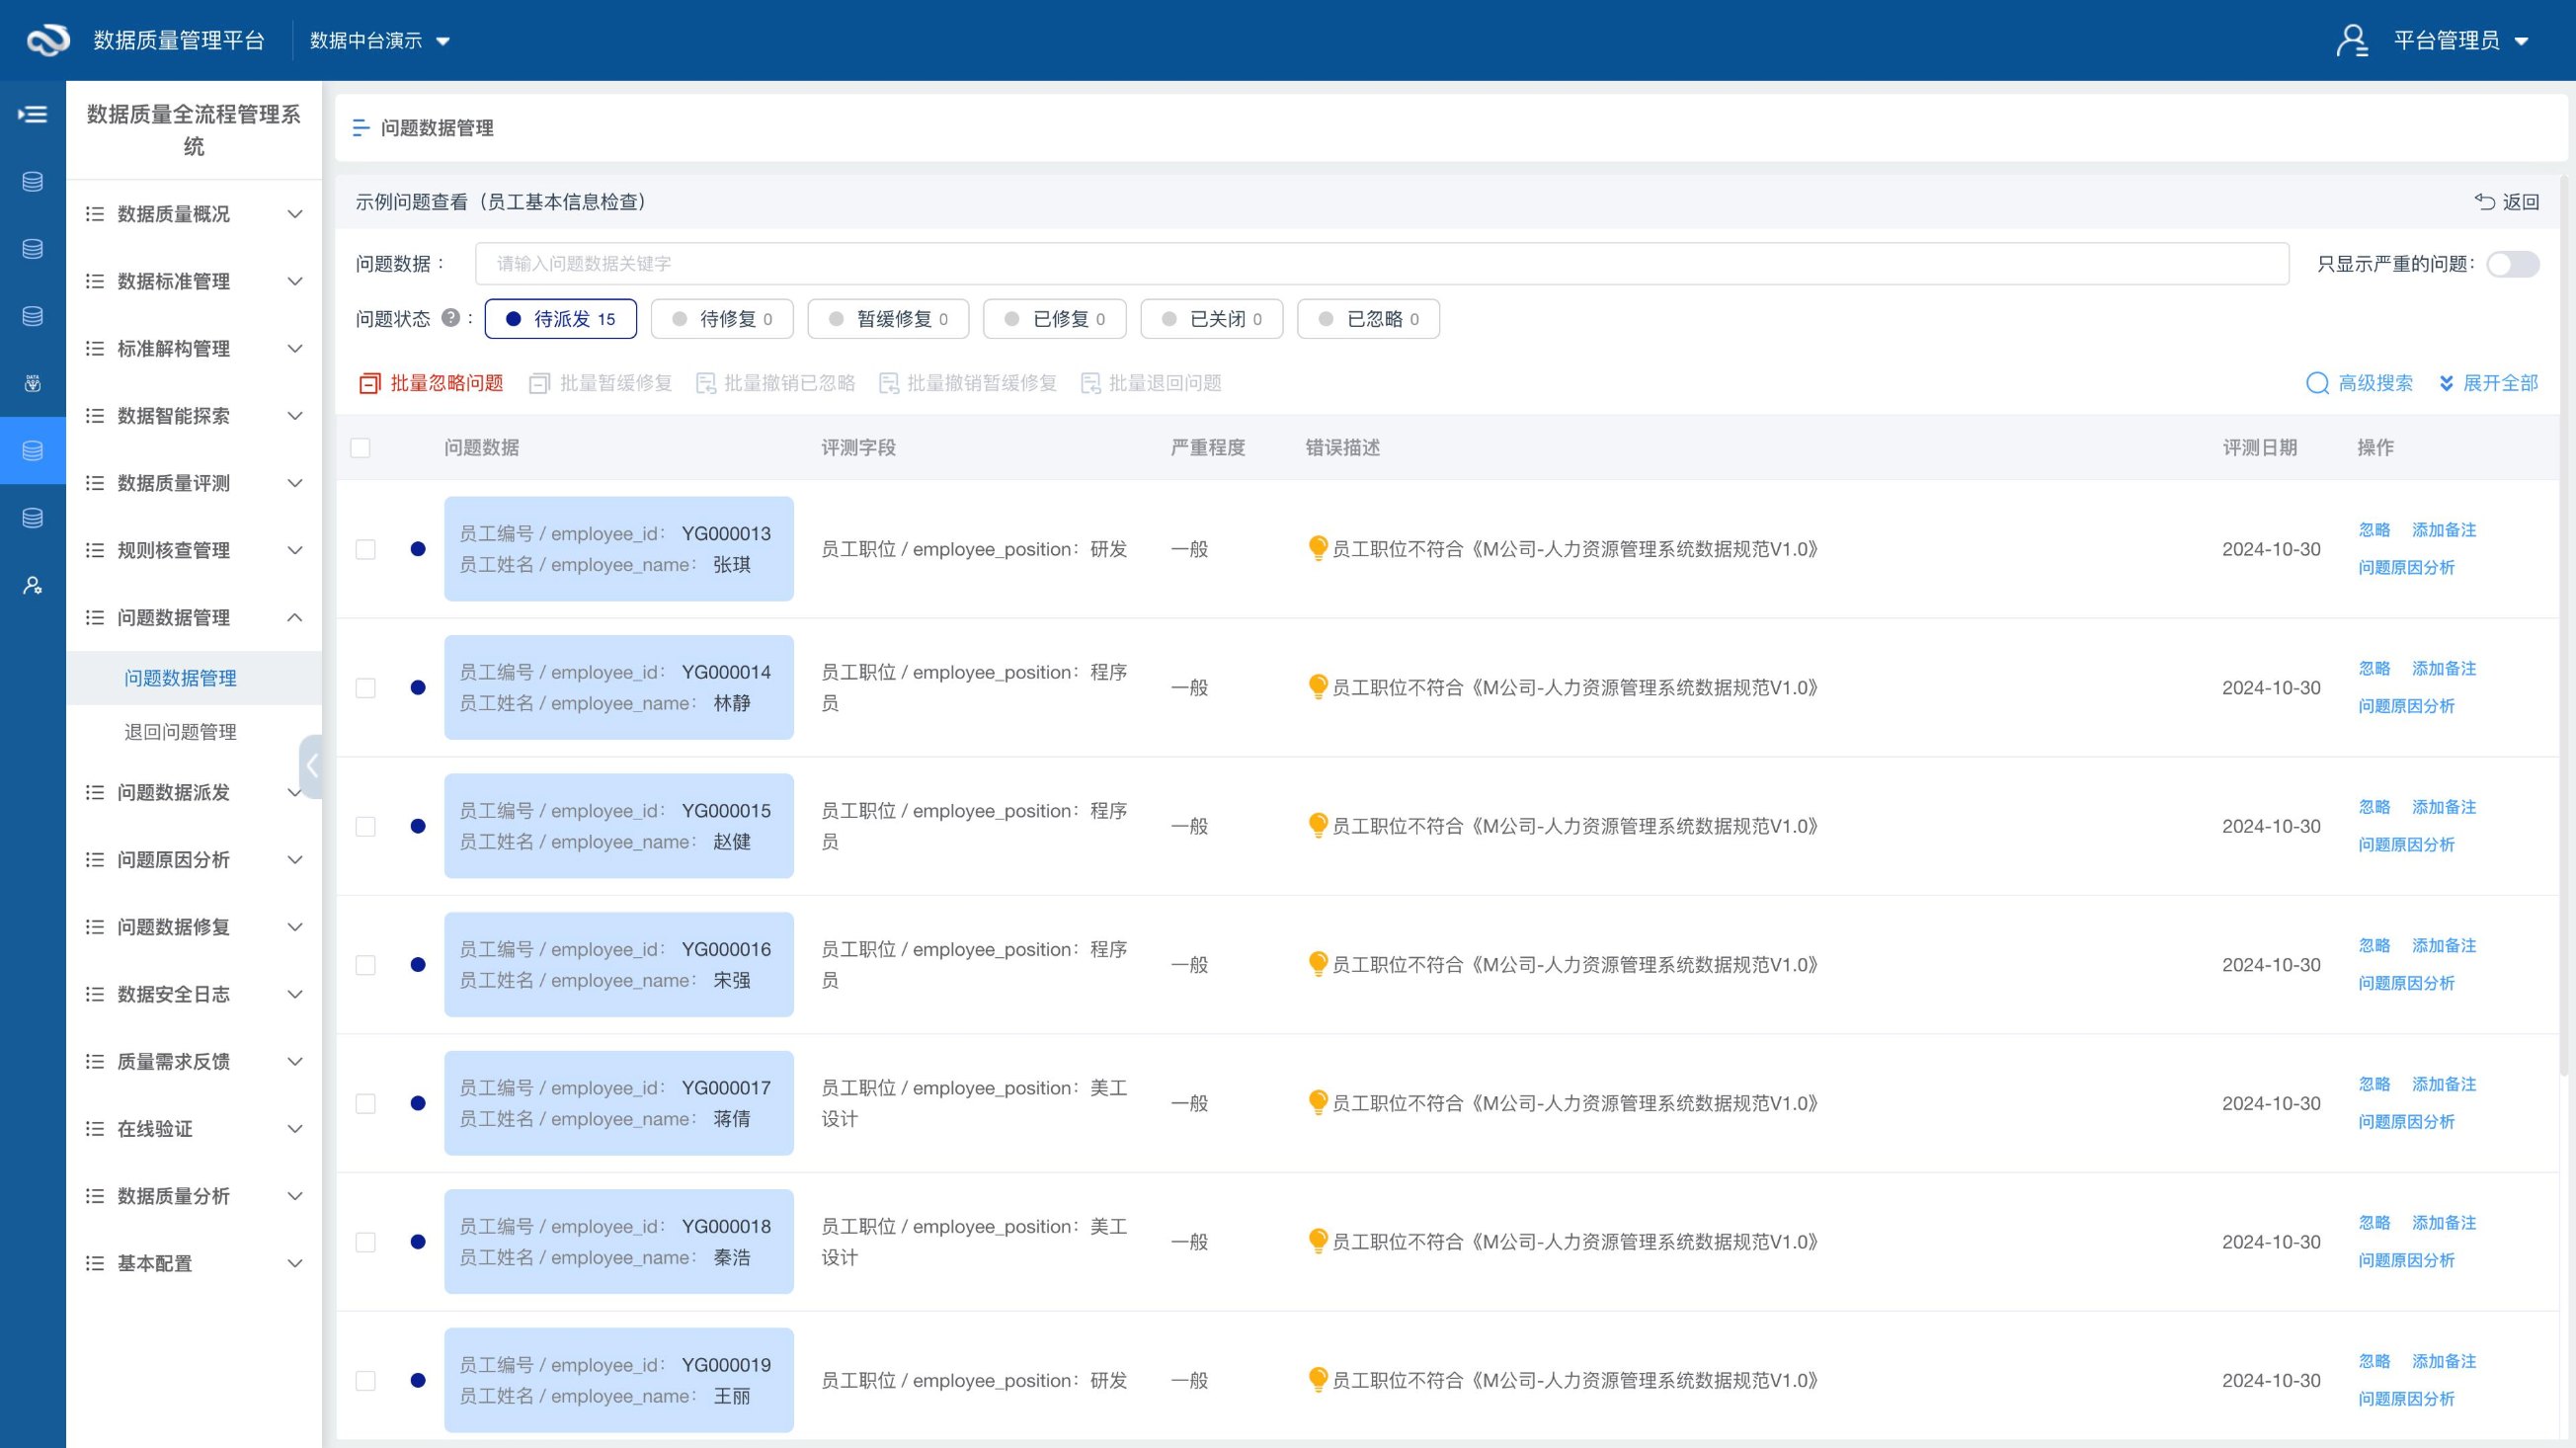
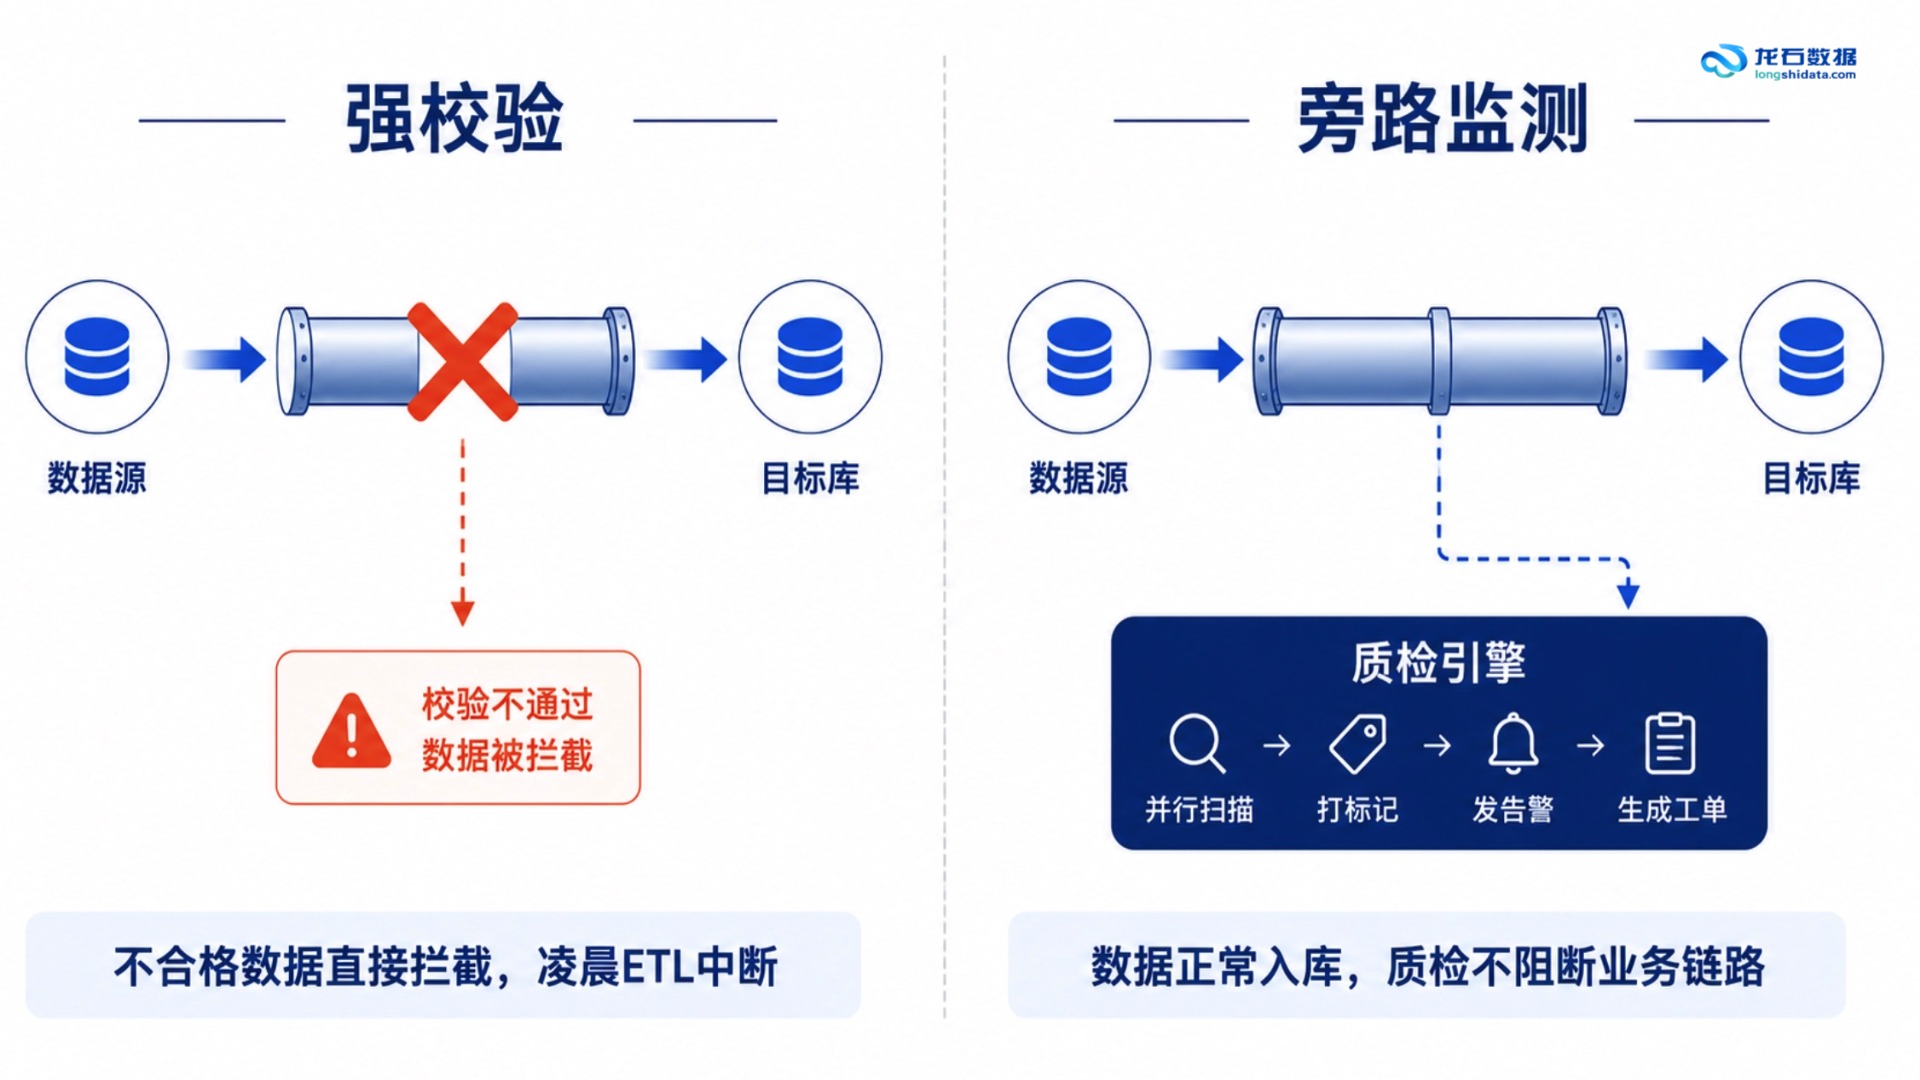
市场部要拉一份客户画像,用来做下周的精准营销。数据中台已经接入了 CRM、ERP 和客服系统,按理说拖几个字段就能出结果。分析同事在 BI 里配好筛选条件,点下查询,出来的结果让人心里一凉: 客户姓名一列,1,200 行是空的 手机号 4,000 多条缺失,800 多条明显是错的(8 位、12 位都有) 性别字段里出现了"M""F""男""女""未知""0"——六种写法,根本没法分组统计 数据接进来了,流转也正常,但问题是——数据本身是脏的,下游谁敢用? 这不是个别现象。很多团队建数据中台,精力全花在"能不能接进来"和"能不能跑通",很少有人关注"接进来的数据对不对"。等到业务部门真要用的时候,才发现数据只能看、不能用。 为什么传统质检方式不够用 常见的做法是两种。 第一种,强校验。 在数据入库前做检查,不合格就拦截。逻辑上没问题,但实际项目里风险很大:一条字段格式的规则配错了,可能把整个管道卡住。凌晨三点的 ETL 任务如果因为一个质量规则报错而中断,运维会被电话叫醒——而且大概率是误报。 第二种,旁路监测。 数据正常同步,质量检查并行运行。发现问题后单独记录到问题库,不阻塞主链路。你可以在白天慢慢修复,不影响任何生产流程。 多数项目里,旁路监测比强校验更实际——这也符合 DAMA 数据管理知识体系中"数据质量管理应优先保障业务连续性"的原则。康桥数据中台的质量管理模块就是这么干的——用"评测模型"管规则,支持 MySQL、Oracle 到 Doris、GaussDB 等一堆数据库,配规则不用写 SQL。作为 DAMA 大中华区实训基地和信通院《数据治理产业图谱 3.0》入选厂商,康桥在这个领域已经有多个项目验证。 上手配置:从零搭建一条质量监控链路 拿最常见的客户基础信息表来跑一遍。customer_info 每天从 CRM 增量同步,要盯三件事:姓名和电话不能空、手机号格式得对、性别代码得在标准字典里。 第一步:创建评测模型 评测模型就是按业务域把规则分组——客户域一个模型、产品域一个、订单域一个。进入「数据质量 → 评测模型管理」,点击新增,填写模型名称"客户信息质量评测",选择评测数据库为治理库(DW),保存。 第二步:添加评测对象 在模型详情页点击新增评测对象,选择 customer_info 表。如果表没有物理主键,需要指定一个逻辑主键来唯一标识每行数据,方便后续问题追溯。 第三步:配置完整性检查 最常见的问题是字段为空,比如客户姓名和电话缺失。新增一条「空值检查」规则: 配置项 填写 规则名称 客户姓名与电话非空检查 检查字段 customer_name,phone 检查方式 每个字段都不能为空 规则权重 高 错误描述 客户姓名或电话存在空值,影响标签生成和营销触达 修复建议 核对 CRM 客户基础信息是否完整录入 第四步:配置准确性检查 字段有值不代表值是对的——手机号是 11 位的吗?年龄在合理范围内吗?性别代码是标准值吗? 格式规范性检查(手机号格式): 规则类型选「格式规范性检查」,检查字段选 phone,EL 表达式写 #phone REGEXP '^1[3-9][0-9]{9}$'。不符合 11 位手机号格式的,自动标记。 值域检查(年龄范围): 规则类型选「值域检查」,检查字段选 age,值域范围设为介于 0 和 120。超出这个区间的数据会被捕获。 引用完整性检查(性别代码标准化): 规则类型选「引用完整性检查」,检查字段选 gender。前提是数据标准模块里已经定义了"性别代码"字典表(M=男/F=女),质检规则直接引用标准定义,不需要重复维护值域。标准改了,规则自动同步。 第五步:创建评测任务 规则配好后,需要建一个评测任务来触发执行。进入「评测任务管理」,选择"客户信息质量评测"模型。首次建议用"手工触发"先跑通验证,确认规则无误后再改为定时策略——比如每天早上 6 点自动跑。 第六步:看结果 任务执行完成后,进入「问题数据查看」。首次扫描 86 万条客户数据,通常能看到类似这样的结果: 问题类型 数量 占比 手机号缺失 4,200 条 0.49% 客户名称缺失 1,200 条 0.14% 手机号格式异常 800 条 0.09% 性别编码不在标准范围 3,500 条 0.41% 合计问题率 1.03% 每条问题都能点开看详情——哪个字段、违了什么规则、当前是啥值、什么时间发现的。修好之后下次跑评测,问题状态自己就关了。 项目里最容易踩的 4 个坑 坑一:规则越多越好。 不是。第一次做数据质量的团队,上来就配几十条规则,觉得覆盖面越广越好。结果每天几千条告警涌进来,没人看得完,也没人处理。两周之后,所有人把告警通知关了。正确做法:从一个核心业务域开始,先配 3-5 条高价值规则,等团队习惯了处理节奏,再逐批加。规则不在多,在有人盯。 坑二:把低价值字段当核心字段。 手机号缺失,值得告警——影响短信触达。备注字段为空,不值得——本来就可空。但很多项目里两者权重设成一样,重要问题淹没在一堆"备注为空"里。区分方法很简单:问自己"这个字段如果错了,下游哪个业务会受影响?"答不上来的,就设低权重或者不配。 坑三:一上来就设定时任务。 评测任务刚建好就设定时,凌晨自动跑——听起来很规范。现实是:第一条规则配错了,半夜产生几千条误报,没人发现,第二天打开系统直接懵了。正确做法:先手工触发跑一次,对着问题清单一条条确认"这是真问题还是误报",确认规则没问题了,再切定时策略。 坑四:错误描述技术部门都看不懂。 见过一个真实案例:规则错误描述写的是"phone 字段不满足 EL 表达式 REGEXP"。业务部门看不懂,技术部门看不出业务影响,这条告警在两个部门之间转了三天没人认领。错误描述应该回答三个问题:什么问题(业务语言)、影响什么(下游场景)、怎么修(可操作的步数)。比如别写"gender 不在值域范围",写"性别字段存在非标准值,影响客户画像分组统计,请在数据标准模块确认标准字典后批量修正"。 真正难的不是发现问题,是把问题推回去 项目做久了会发现一个规律:大部分质量问题并不是系统故障造成的,而是业务过程产生的。客服录入时图省事,手机号随便填。老系统迁移时历史数据没清洗,脏数据原封不动搬过来。ERP 和 CRM 对"客户类型"各有各的编码规则,合到一起全乱了。质量规则能扫描出来的,只是冰山浮在水面上的部分。 更棘手的是:你标记了 4,000 条手机号缺失,谁来补?客服部说"这是历史数据,不是我录的",IT 说"数据已经同步完了,源系统不改我们也没办法"。一圈下来,问题清单躺了一个月没人动。 所以旁路监测真正的价值,不是发现问题——发现很容易,配几条规则就够了。真正的价值是给一个持续推动的抓手:每周把问题清单按来源系统分类,谁产生的谁认领。一次不行两次,两次不行拉上业务负责人一起看数据。质量管理要解决的不是一次性清洗,而是让问题回到业务源头的能力。 常见问题 Q1:旁路监测会影响数据同步性能吗? 一般不会。质量评测是数据同步完之后另外跑的,跟主链路不打架。头一回跑的时候留意下耗时,千万级往上的大表可以用分区评测或者增量评测,别一次扫全表。 Q2:发现问题数据后,系统会自动修复吗? 不会。质量管理的任务是发现问题和推动治理,不是直接改业务数据。问题数据进问题库,标清楚哪条记录、谁负责、怎么修。等业务侧改好了,系统会自动把这条问题关掉。 Q3:什么时候用旁路监测,什么时候用强校验? 不冲突。身份证号、统一社会信用代码这种核心交易数据,强校验合适。客户信息、设备信息、业务标签这些,用旁路监测更稳——别因为几条破数据把整个流程卡了。 Q4:质量规则应该一次性全部配完吗? 别。先盯核心字段,把 80% 的高价值问题干掉,跑顺了再慢慢加。上来就全配,告警多到自己都不想看。 Q5:数据质量问题主要来自哪里? 很多团队第一反应是同步任务出了问题。其实大部分质量问题是业务侧搞出来的:录入的时候图省事、老系统迁移过来的脏数据没洗、不同系统对同一个字段各有各的编码。所以数据质量治理,治的不是数据,是业务过程。 很多人以为数据质量就是上线前集中洗一轮,洗完就干净了。实际上数据质量跟产线质检差不多——每天都有新料进来,质检得一直跑着,不是搞一次就收工。 评测模型和定时任务搭好之后,每周扫一眼问题修复率就行。主要看三样:问题数是在涨还是在降、高权重问题从发现到关闭用了几天、新接的数据源有没有同步建质检规则。 说到底,数据质量不是要把所有问题都干掉——那不可能。是得有一个"一直在查、查出来有人修"的机制。旁路监测做的就是这件事。 截至 2026 年,越来越多的企业数据中台项目从"建设期"进入"运营期",数据质量的持续管理正在成为新的焦点。